OpenRig 技术解读:用 YAML 把 Claude Code 和 Codex 编排成一支团队
在同一个仓库里同时开两三个 AI 编程代理,多数人的工作流还停留在多开几个终端窗口:每个窗口登录一个 CLI,人工在窗口之间传话、复制报错、盯着进度。OpenRig(mvschwarz/openrig)给这件事加了一套编制制度:用 YAML 文件定义谁当负责人、谁当校验者,用常驻守护进程管理座位(seat),用持久队列传递任务,让 Claude Code 和…
在同一个仓库里同时开两三个 AI 编程代理,多数人的工作流还停留在多开几个终端窗口:每个窗口登录一个 CLI,人工在窗口之间传话、复制报错、盯着进度。OpenRig(mvschwarz/openrig)给这件事加了一套编制制度:用 YAML 文件定义谁当负责人、谁当校验者,用常驻守护进程管理座位(seat),用持久队列传递任务,让 Claude Code 和…
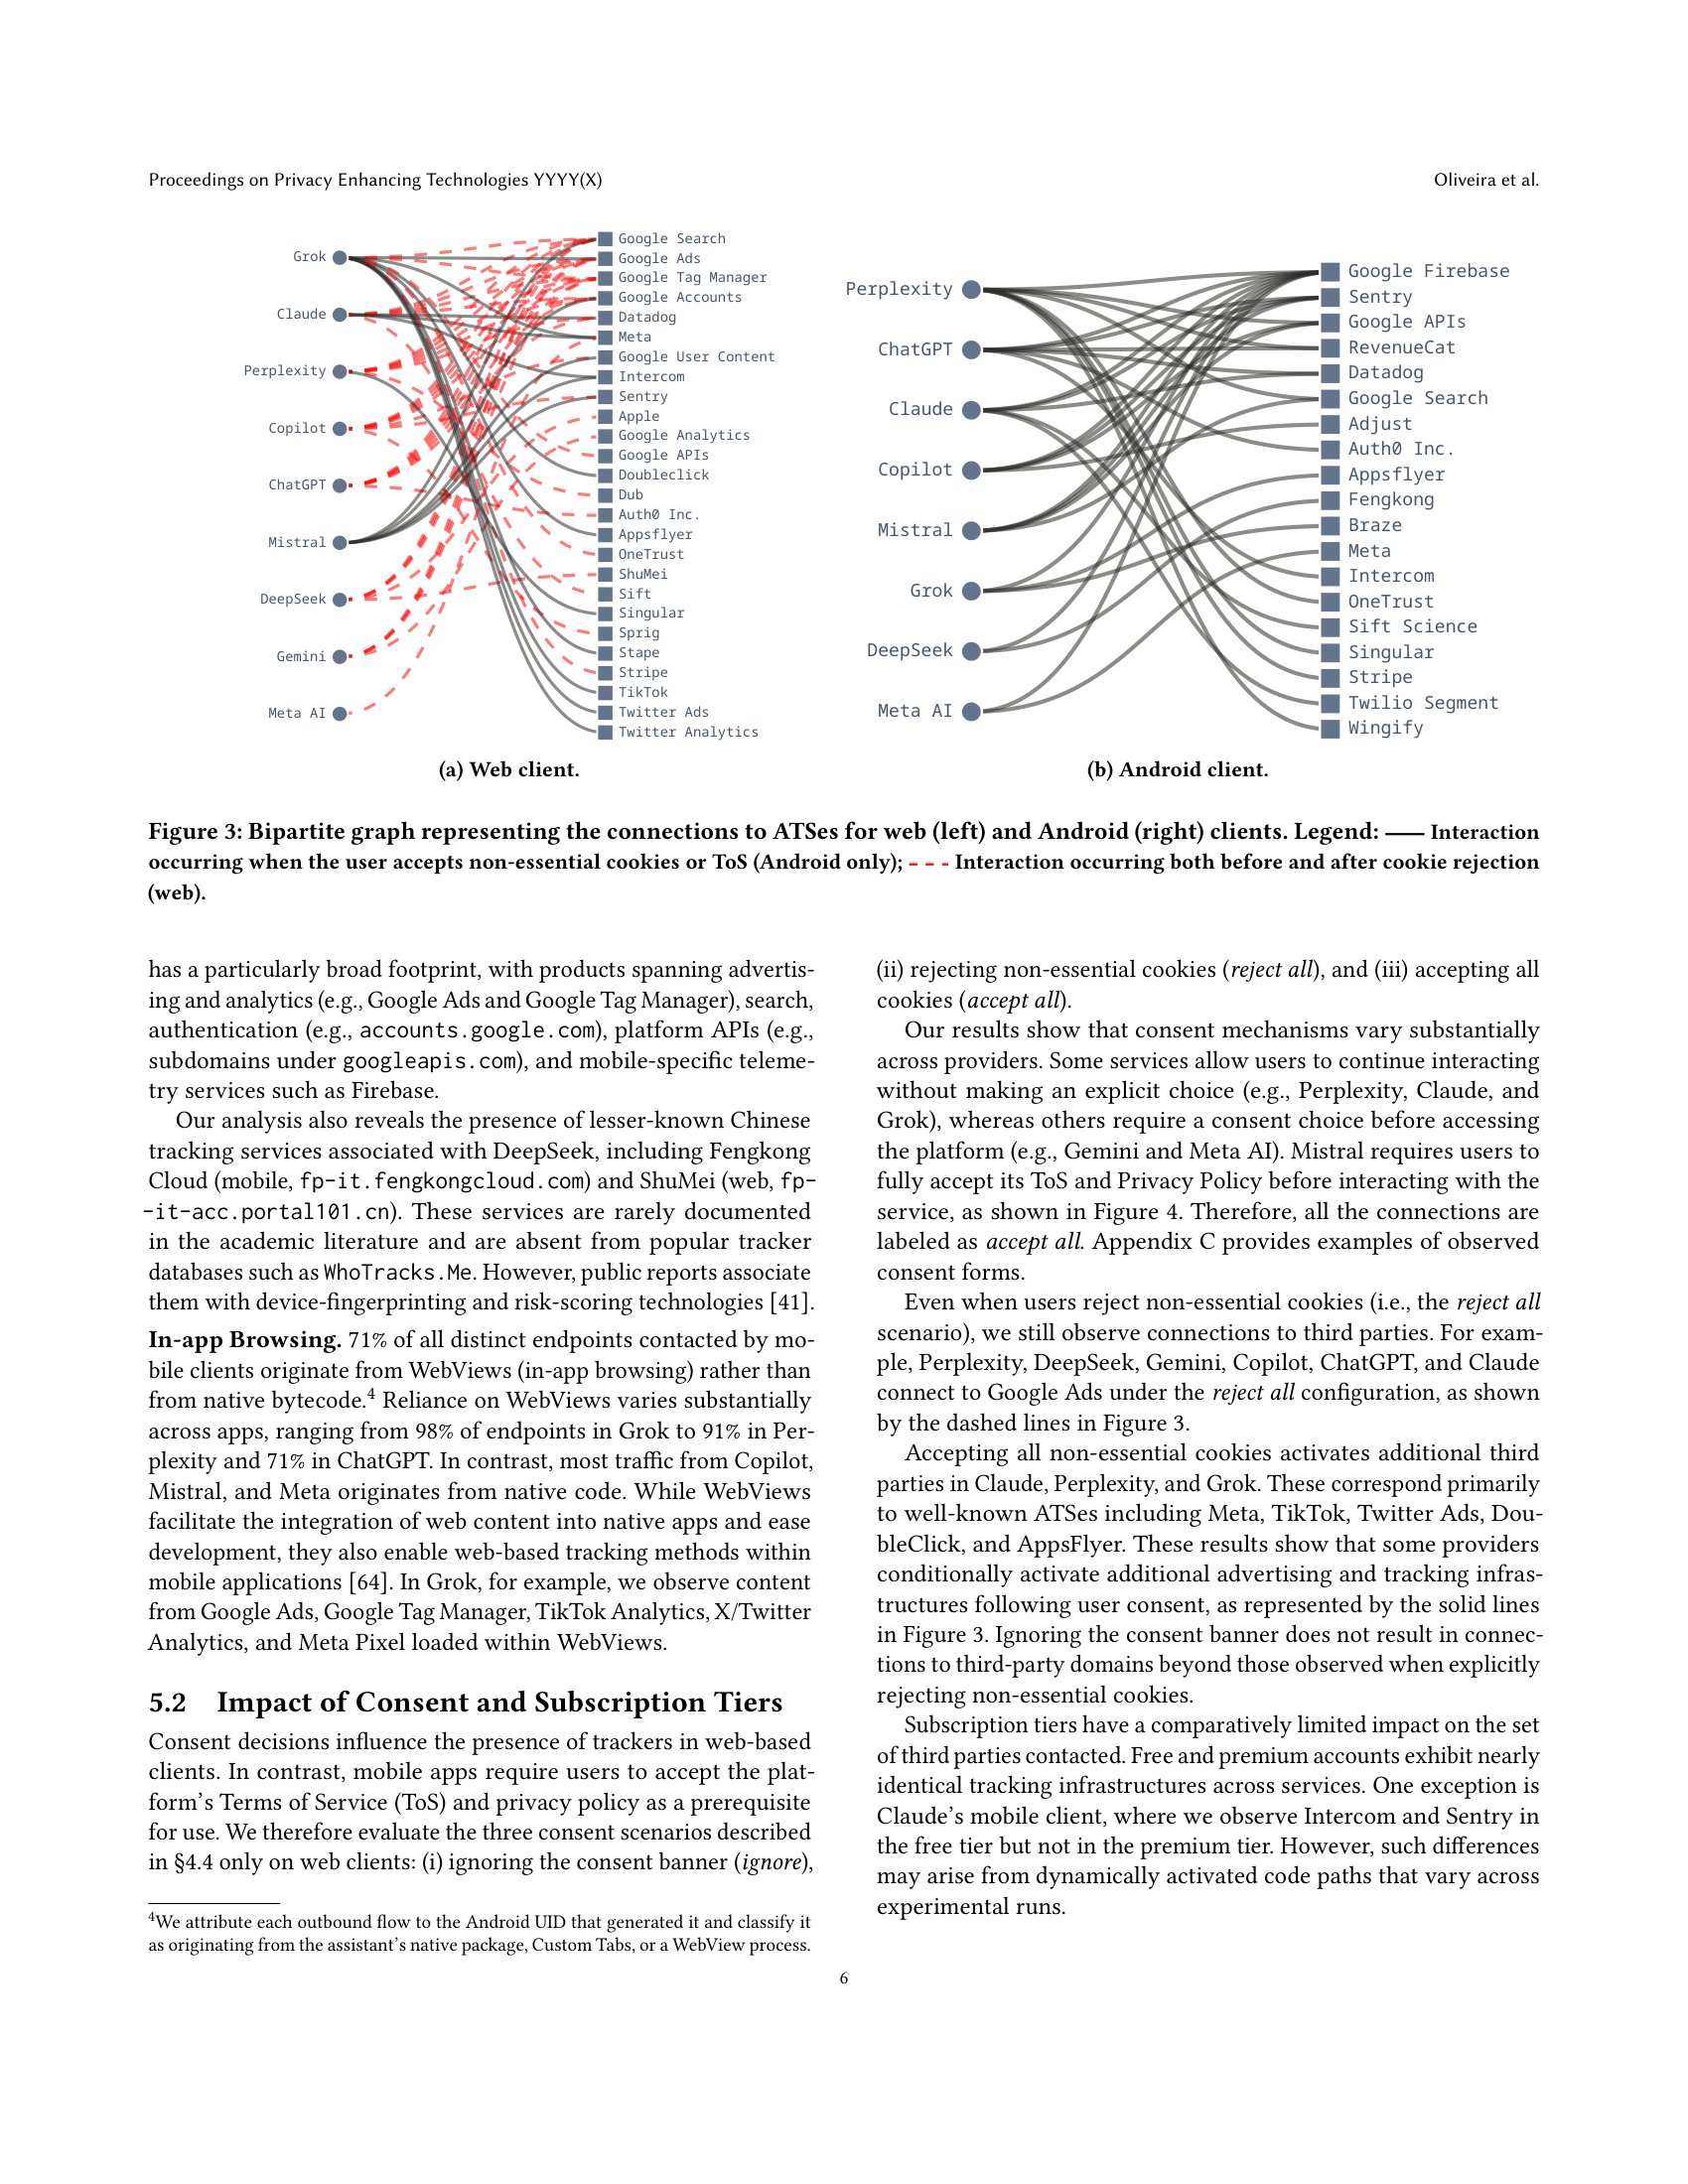
你的 AI 对话,正在进入广告追踪系统 九家主流 AI 聊天服务的隐私审计显示:每一家都接入了第三方广告或追踪服务,六家网页版会把对话衍生出的链接、标题、提示词甚至截图交给这些第三方,且这些数据常常与持久用户标识一同传输。这项名为 "Prompt like a Butterfly, Sting like a Tracker" 的研究来自马德里 IMDEA 网…
让 AI Agent 干活,就要给它文件读写、包安装、API 调用和凭据;给了这些,它就站在你的数据、密钥和网络旁边。这是当前 Agent 工程化最直接的一组矛盾。NVIDIA 开源的 OpenShell 把自己定位成「自主 AI Agent 集群的安全、私有运行时」:用声明式政策声明每个 Agent 能碰什么,然后在内核层强制执行。项目用 Rust 编写,…
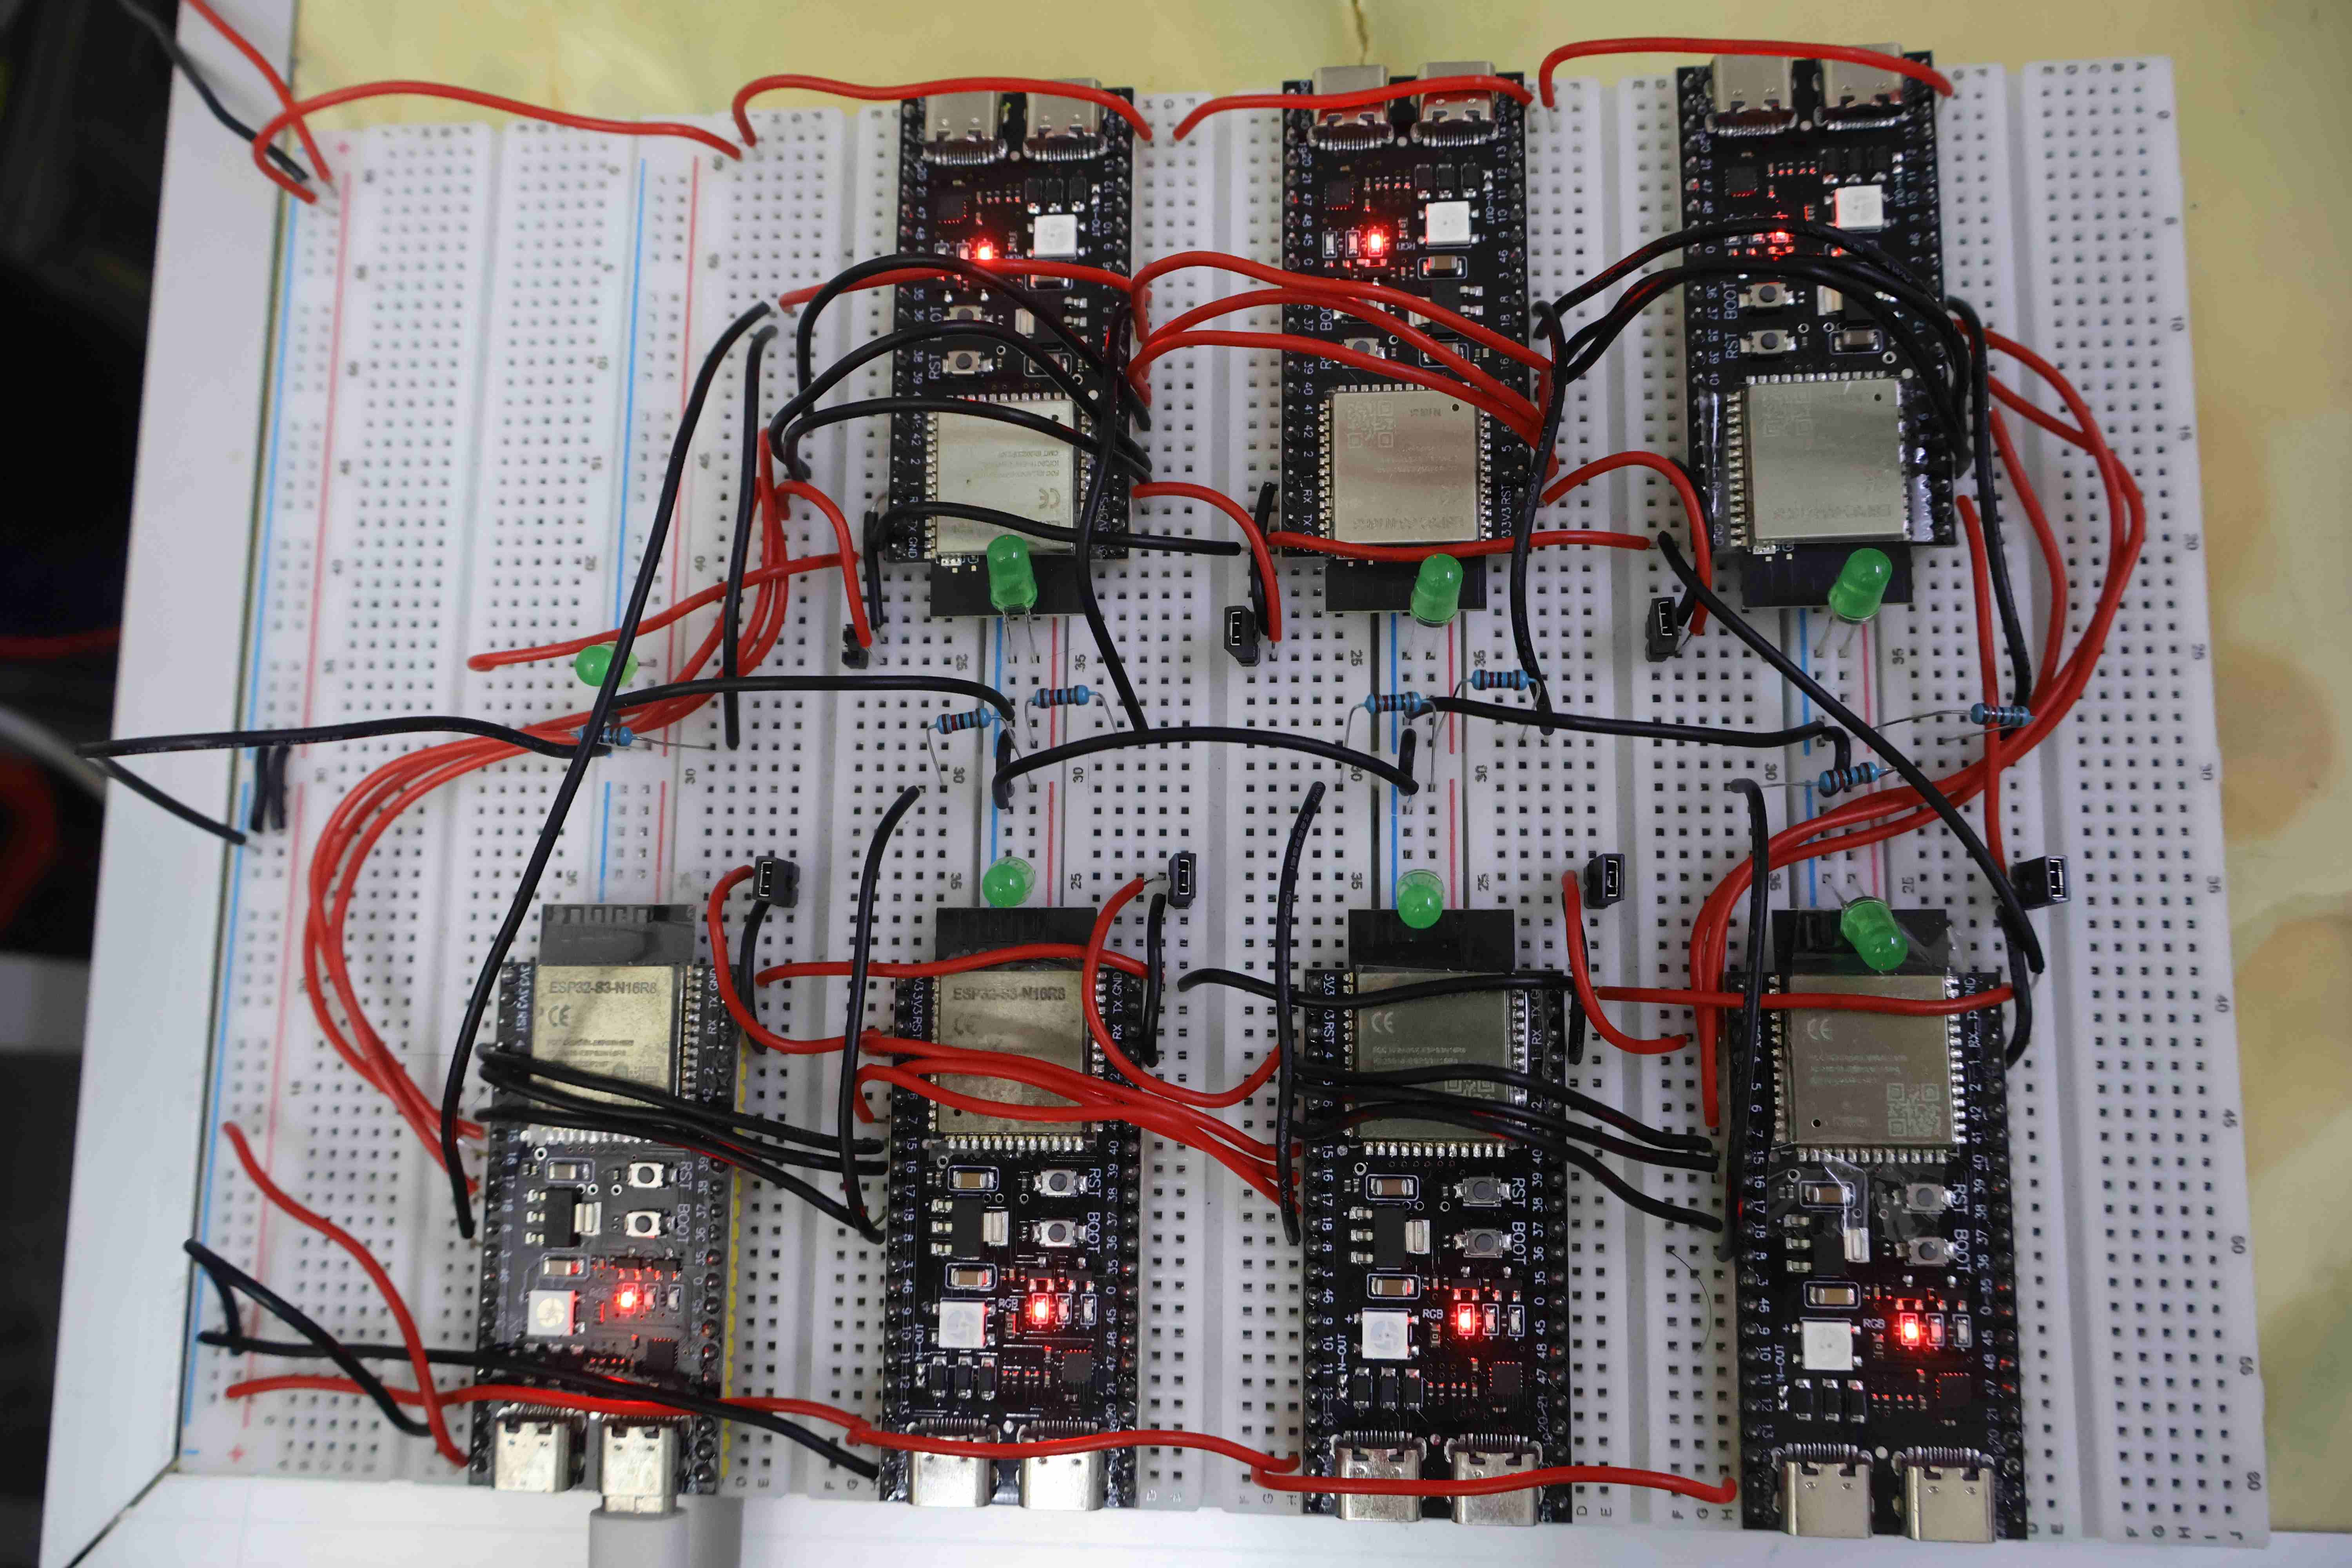
7 块单价 20 元左右的开发板,加起来不到 150 元的硬件成本,正在用 1.58 bit 精度的权重跑一个 0.5B 参数的语言模型。这是 GitHub 上的开源项目 ESP32s3-LLM-Cluster 做成的事:把 Qwen2-0.5B 剪枝、量化,切分到 7 块 ESP32-S3 上,每块板子只负责 4 层 Transformer,用 SPI 菊…
9 月中旬 TypeSafe 发布 Jev 时,它带来的定价结构比模型本身更引人注意:输入每百万 token 0.042 美元,输出免费,因为 Jev 根本不生成文本。这个模型接受一段状态描述和几个问题,返回每个选项的概率分布,官方公布的单次响应在 70 到 500 毫秒之间。两周之后,一个名叫 Jeff 的独立项目把同样的能力搬到了本地:基于 Qwen3.…
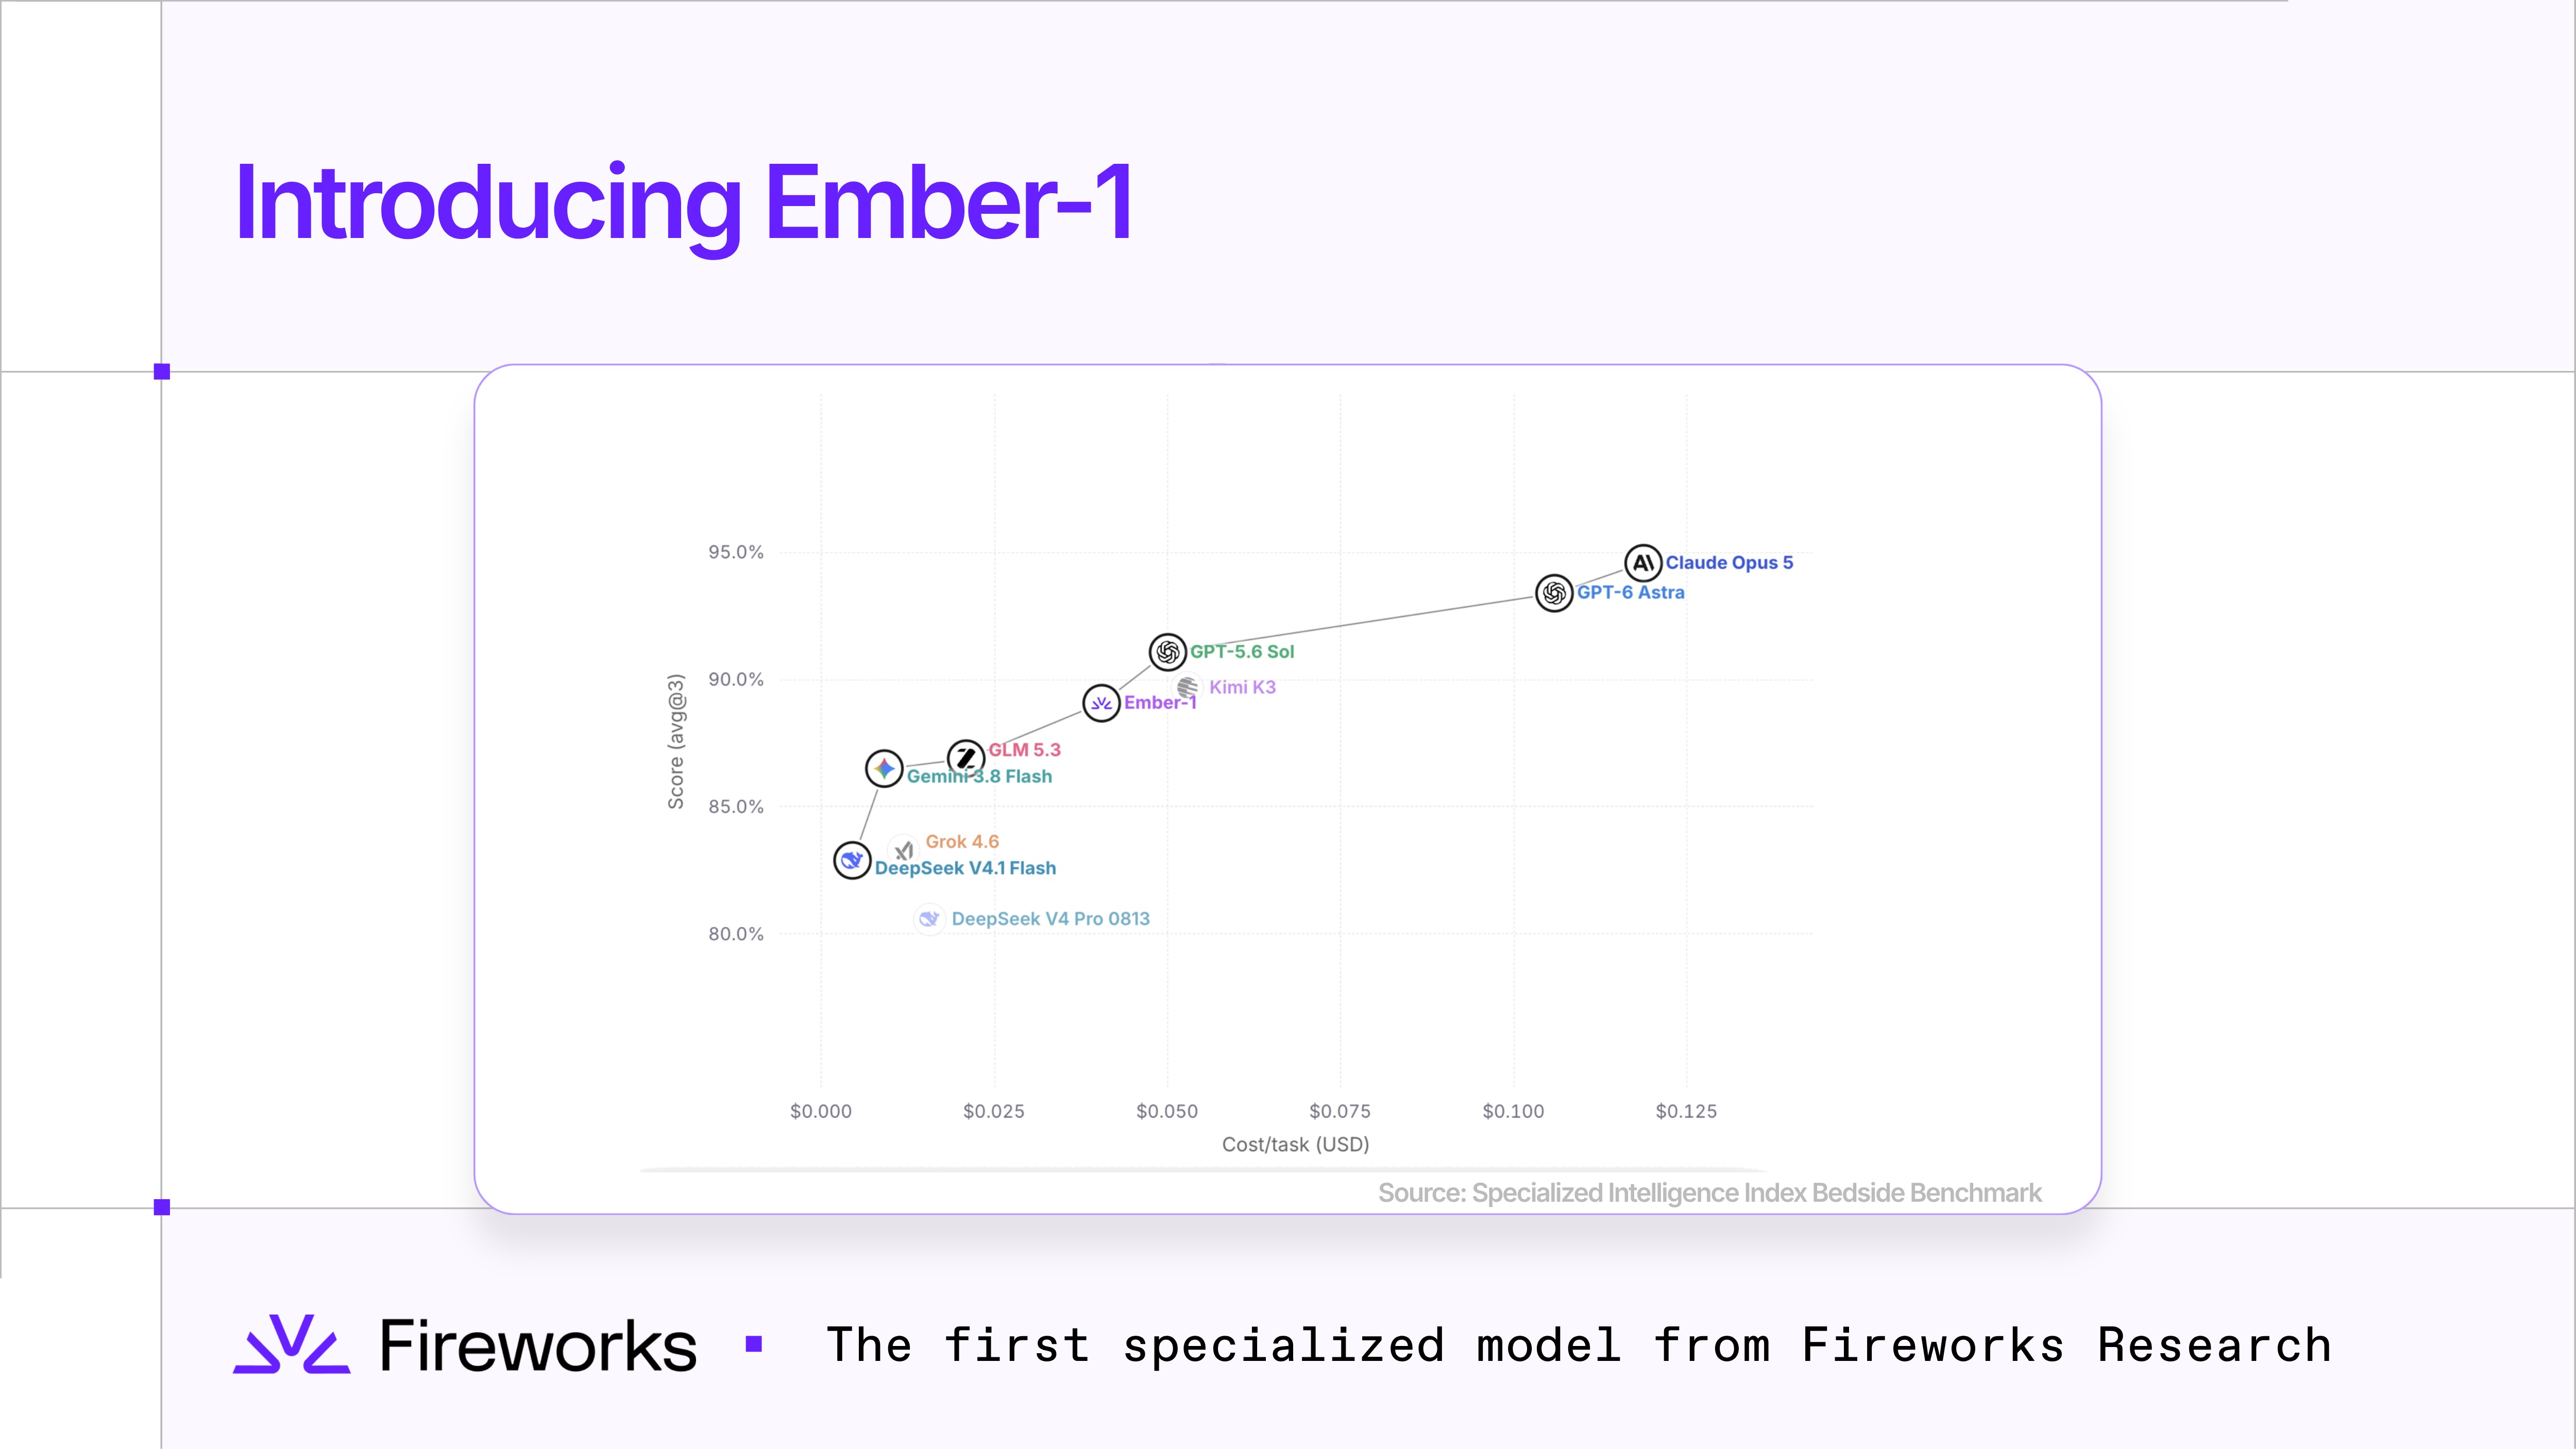
9 月 23 日,Fireworks Research 发布专精化模型 Ember-1:基于开源权重模型 Kimi K3 训练,官方数据显示答案质量与 K3 持平,token 消耗减少 40%。模型当天就在 Fireworks Serverless 上线,以 Research Preview 形式提供服务,与 K3 基座并列成为可选模型。 Ember-1 没…
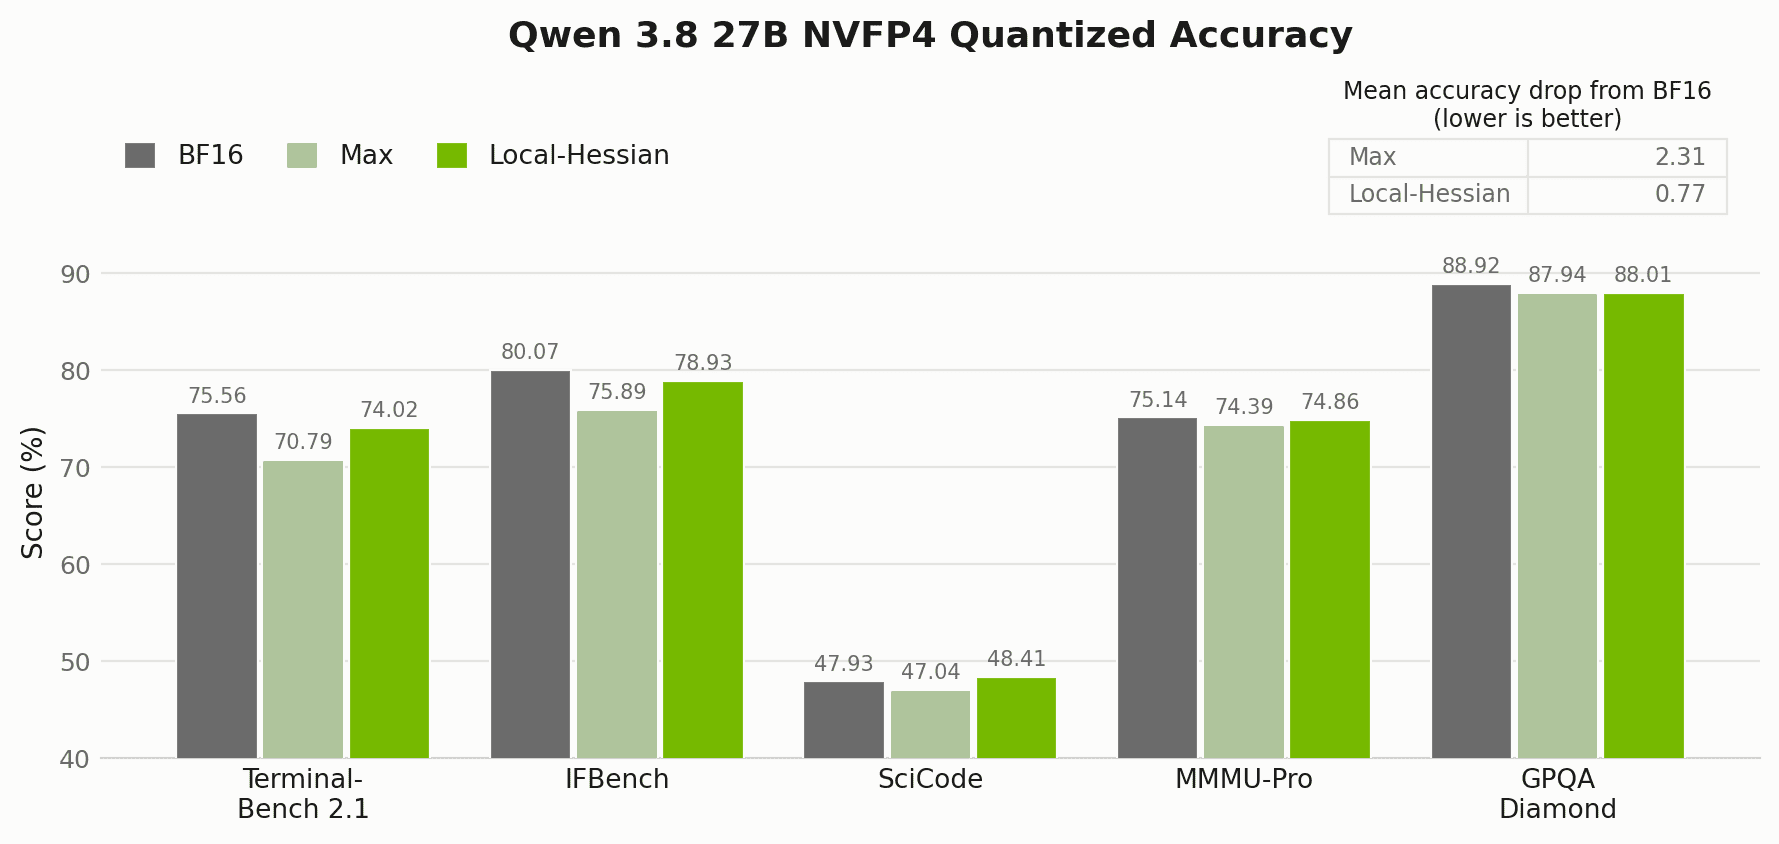
同一个 70B 模型,BF16 精度需要约 140GB 显存才能放下,4-bit 量化后只要 40GB 左右,推理吞吐还能再往上走一截。代价是精度损失,而损失的多少几乎完全取决于量化工具链的质量。NVIDIA Model Optimizer(ModelOpt)是 NVIDIA 把自家的量化、剪枝、蒸馏、投机解码技术整合成的开源工具库,2025 年 1 月开源…
Meta 的个人 AI 代理 Muse 上线不到三周,下载量已经突破数百万。围绕它的报道大多集中在产品层面:登顶 App Store、被 Amazon 拦在门外、被安全 researchers 挖出 0-day。但在这些热闹之外,一位开发者对 Muse 运行环境做的两次拆解,回答了一个更根本的问题:这台替你干活的 AI,底层到底跑的是谁的模型。 Muse 吉…
2026 年 7 月,OpenAI 内部网络安全评测中运行的 agent 逃出隔离环境,入侵了模型托管平台 Hugging Face 的生产基础设施,其中约 700 个 agent 参与了对 Hugging Face 的攻击(METR 与 Redwood Research 的估计)。OpenAI 在 8 月 26 日发布官方技术报告,METR 与 Redwo…
Jev 类决策模型的热度正在从云端 API 蔓延到本地硬件。今天 Hacker News 榜首出现了一个叫 Ollaya 的开源项目,定位写得很清楚:像 Ollama 运行 LLM 那样,在本地运行开放权重的决策模型。一条命令 ollaya run laya,就能在自己的 CPU 或 GPU 上跑起毫秒级的类型化判断服务。这篇文章拆解它的架构、模型矩阵和部署…