ESP32s3-LLM-Cluster:7 块 20 元开发板菊花链跑 BitNet 1.58-bit 大模型
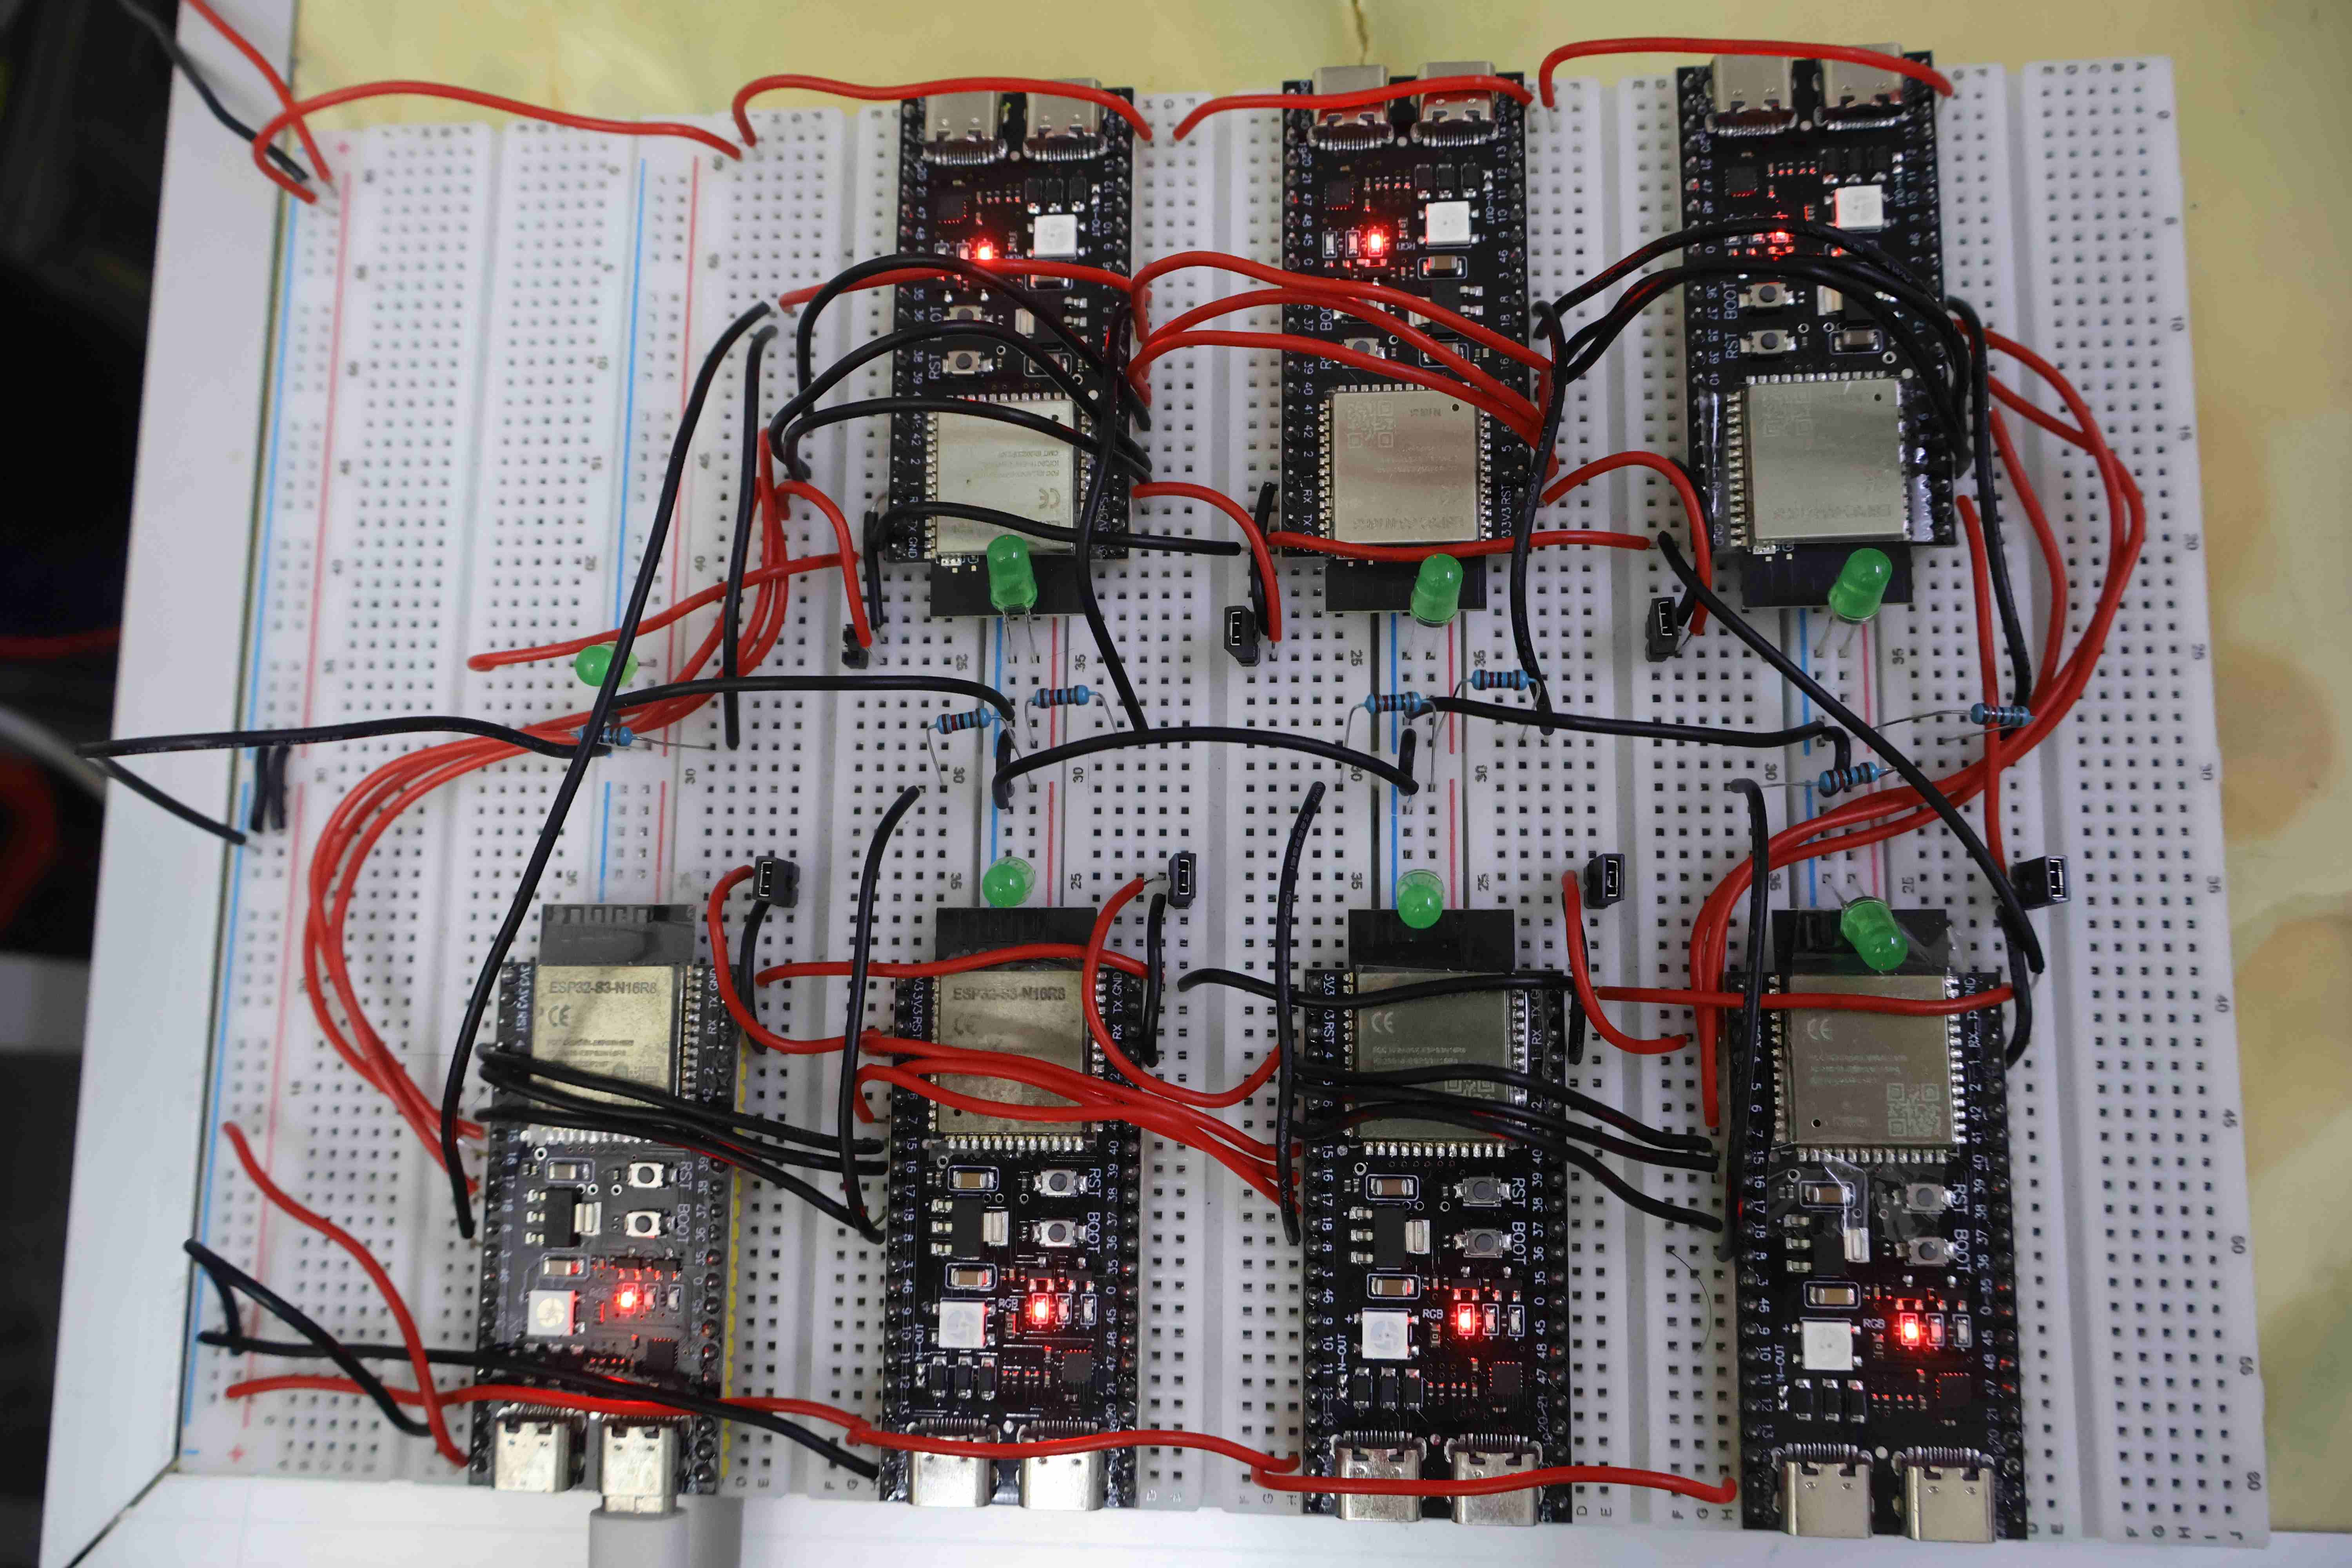
7 块单价 20 元左右的开发板,加起来不到 150 元的硬件成本,正在用 1.58 bit 精度的权重跑一个 0.5B 参数的语言模型。这是 GitHub 上的开源项目 ESP32s3-LLM-Cluster 做成的事:把 Qwen2-0.5B 剪枝、量化,切分到 7 块 ESP32-S3 上,每块板子只负责 4 层 Transformer,用 SPI 菊…
7 块单价 20 元左右的开发板,加起来不到 150 元的硬件成本,正在用 1.58 bit 精度的权重跑一个 0.5B 参数的语言模型。这是 GitHub 上的开源项目 ESP32s3-LLM-Cluster 做成的事:把 Qwen2-0.5B 剪枝、量化,切分到 7 块 ESP32-S3 上,每块板子只负责 4 层 Transformer,用 SPI 菊…
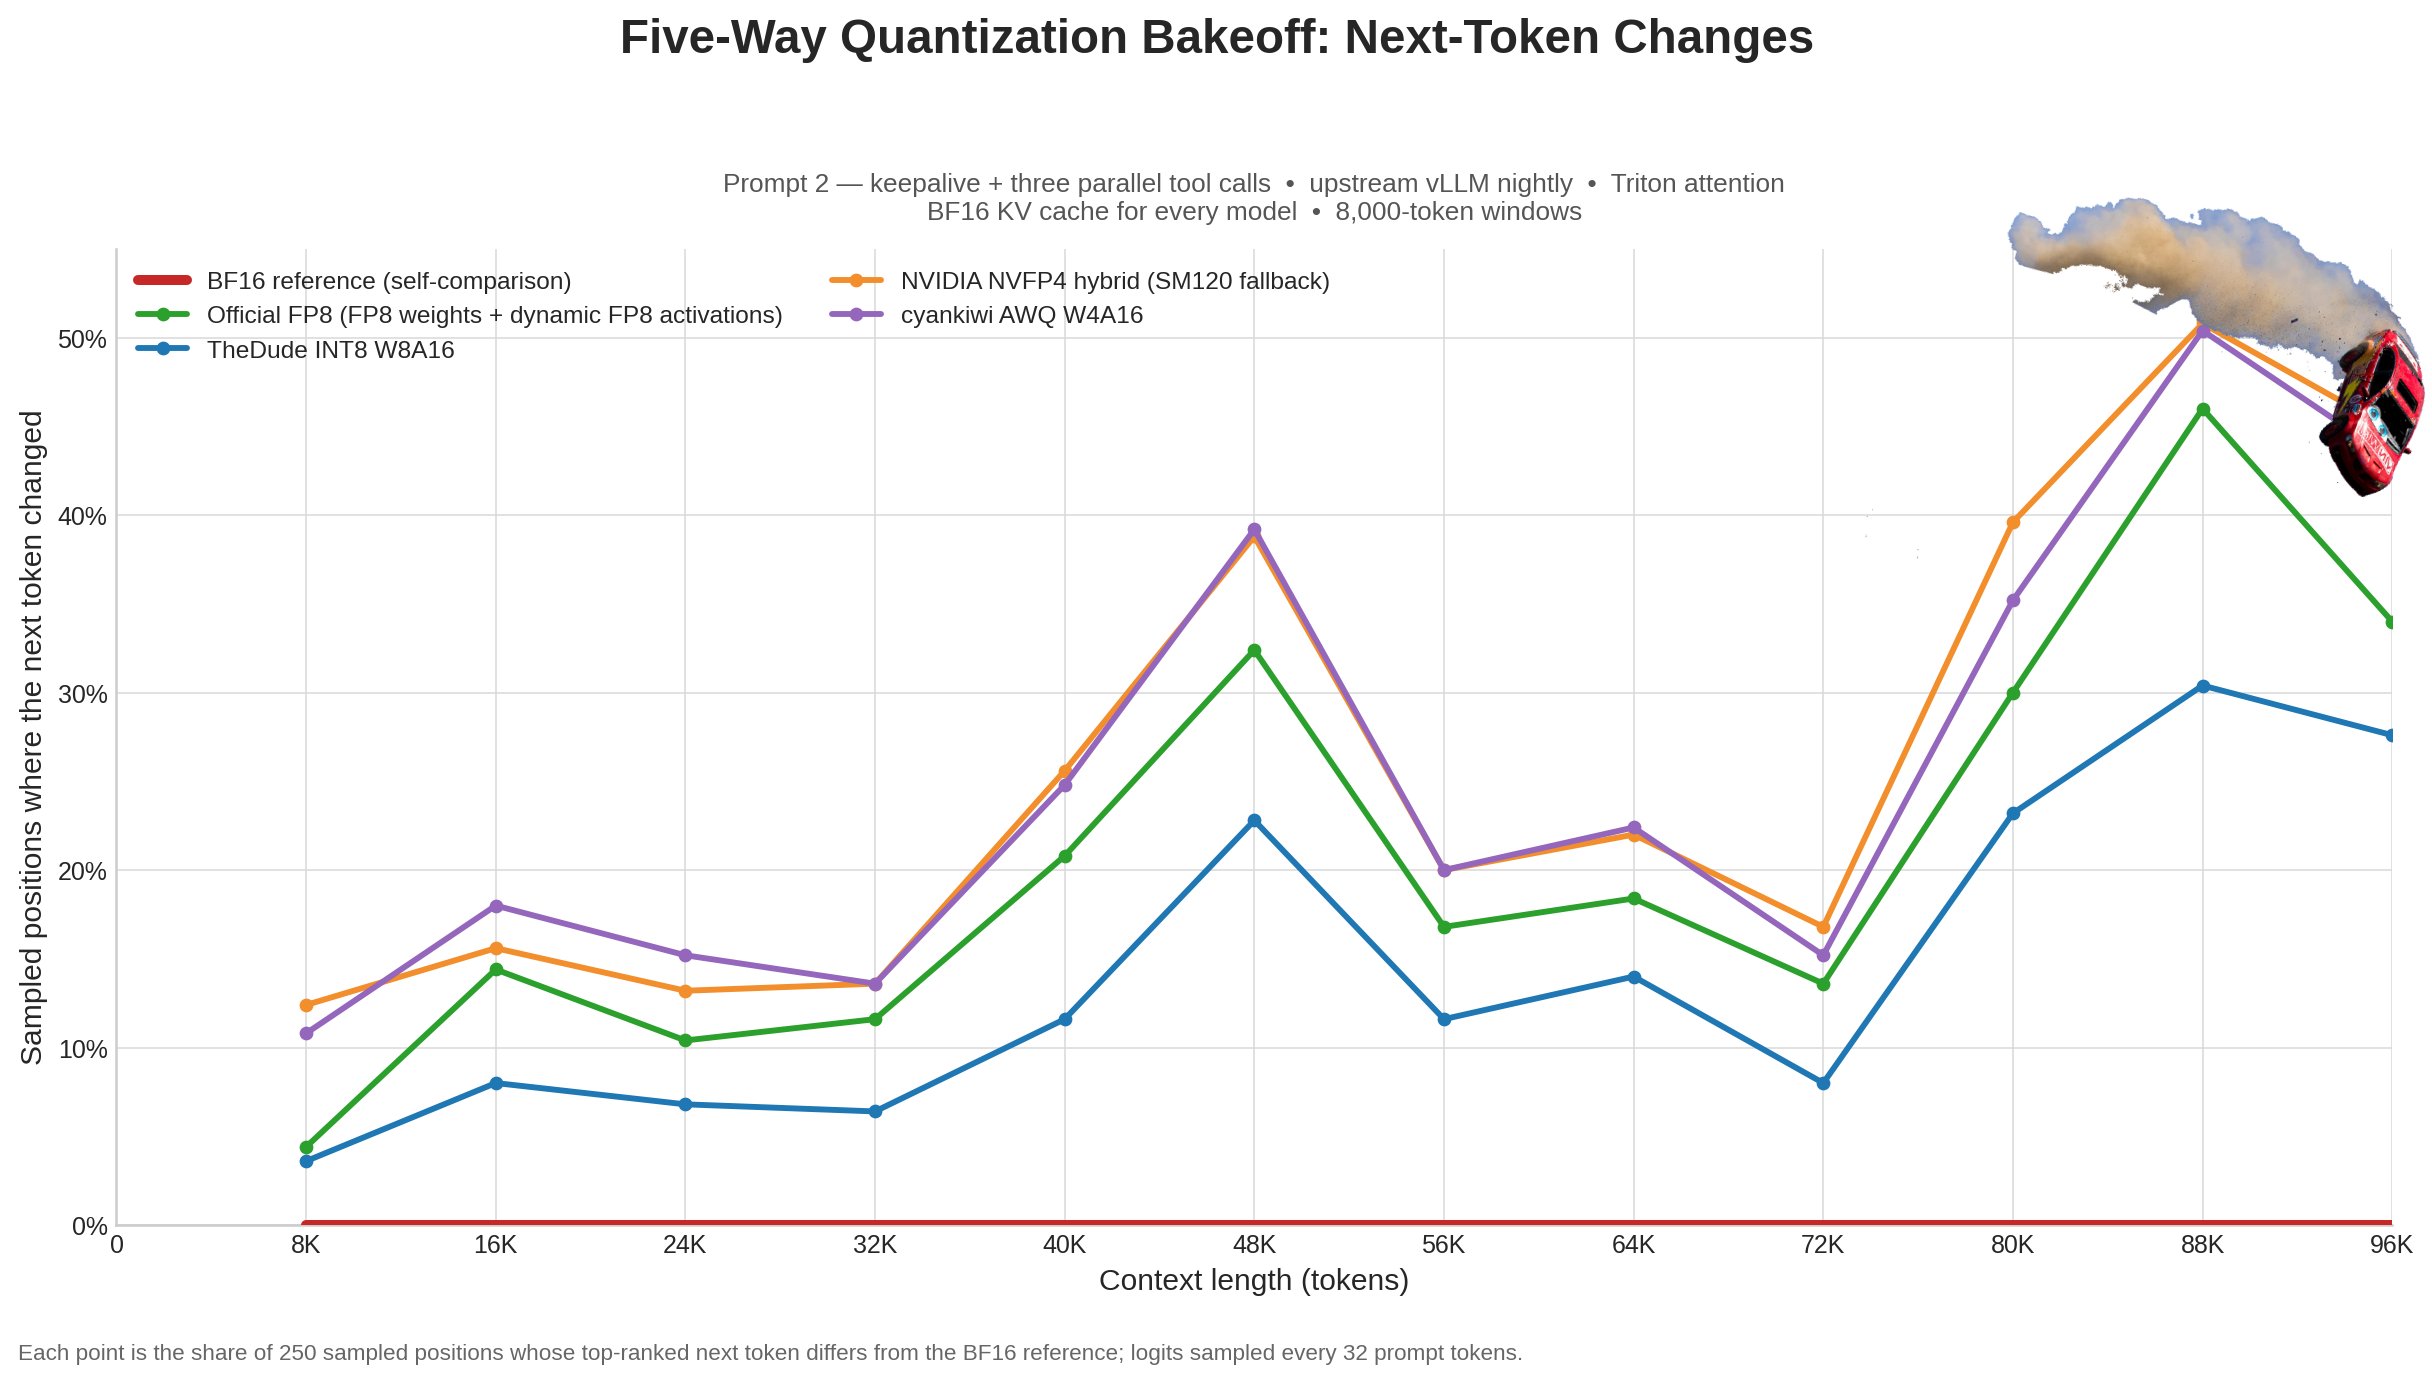
同一份模型权重,在官方演示里对答如流,部署到本地却频繁表现失常:长上下文读到后半段输出开始漂移,量化版本连工具调用都闭合不了。Level1Techs 论坛上一篇带完整数据的受控实验《Why your local LLM feels dumber than it is》把原因指向了推理软件栈:从注意力算子到量化 kernel,每一层都在改变下一个 token…
大模型量化详解:从 FP16 到 Q4KM 该怎么选 本地部署大模型时,你一定会遇到一个问题:该下哪个版本?HuggingFace 上同一个模型往往有十几个文件——Q4KM、Q5KS、Q80、FP16……它们之间到底差多少?选错了要么跑不动,要么浪费内存。 这篇文章把量化的原理、各级别的真实区别、以及不同硬件该怎么选一次讲清楚。 量化在做什么 一个训练好的模…