Strata 技术解读:125B 模型跑进 12GB 显存的游戏本
Hacker News 一条 543 分的帖子标题是「Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s」。发帖人 snehesht 在评论里给出了自己的配置:RTX 4090、128GB DDR5 内存、Ryzen 7950X3D,实测输出速度 124 token…
Hacker News 一条 543 分的帖子标题是「Run Qwen 3.8 Flash Next (125B) on consumer hardware (RTX 4090) at 100T/s」。发帖人 snehesht 在评论里给出了自己的配置:RTX 4090、128GB DDR5 内存、Ryzen 7950X3D,实测输出速度 124 token…
9 月中旬 TypeSafe 发布 Jev 时,它带来的定价结构比模型本身更引人注意:输入每百万 token 0.042 美元,输出免费,因为 Jev 根本不生成文本。这个模型接受一段状态描述和几个问题,返回每个选项的概率分布,官方公布的单次响应在 70 到 500 毫秒之间。两周之后,一个名叫 Jeff 的独立项目把同样的能力搬到了本地:基于 Qwen3.…
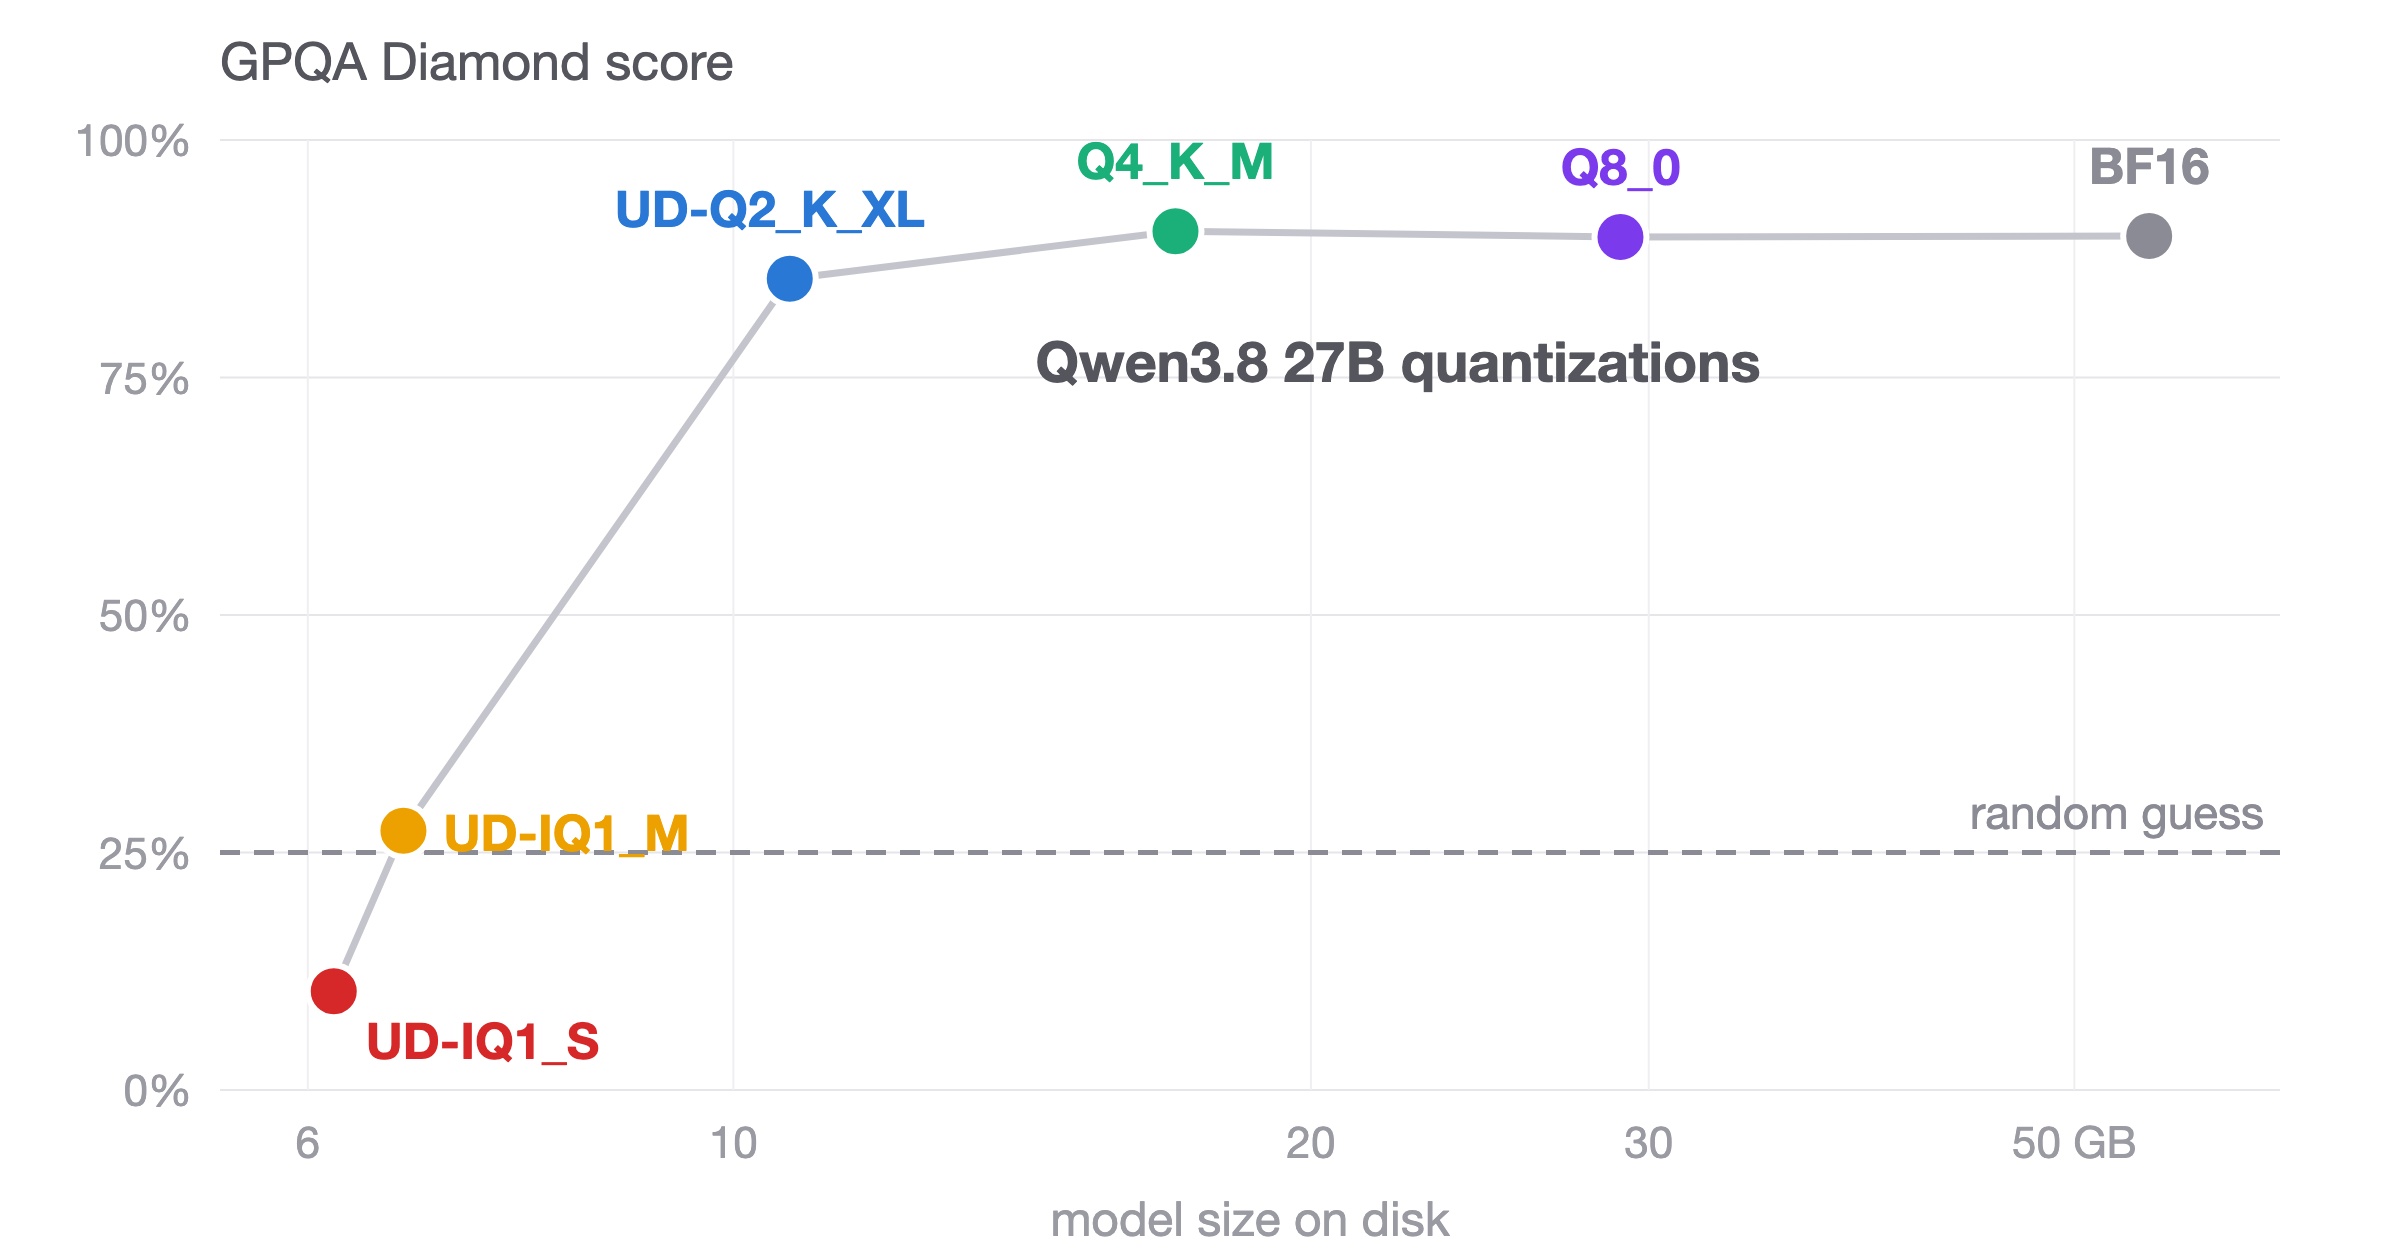
把一个 55GB 的开源模型压到 17GB,跑分几乎不动;继续压到 6.2GB,它的成绩掉到瞎猜水平以下。Quesma 工程师 Piotr Migdał 8 月 26 日发表的实测,把阿里千问 Qwen3.8 27B 的五个量化档位逐个放上三个基准,量出了这条异常清晰的分界线。整轮测试在 Modal 租用 GPU 上完成,llama.cpp 推理,总计烧掉约…
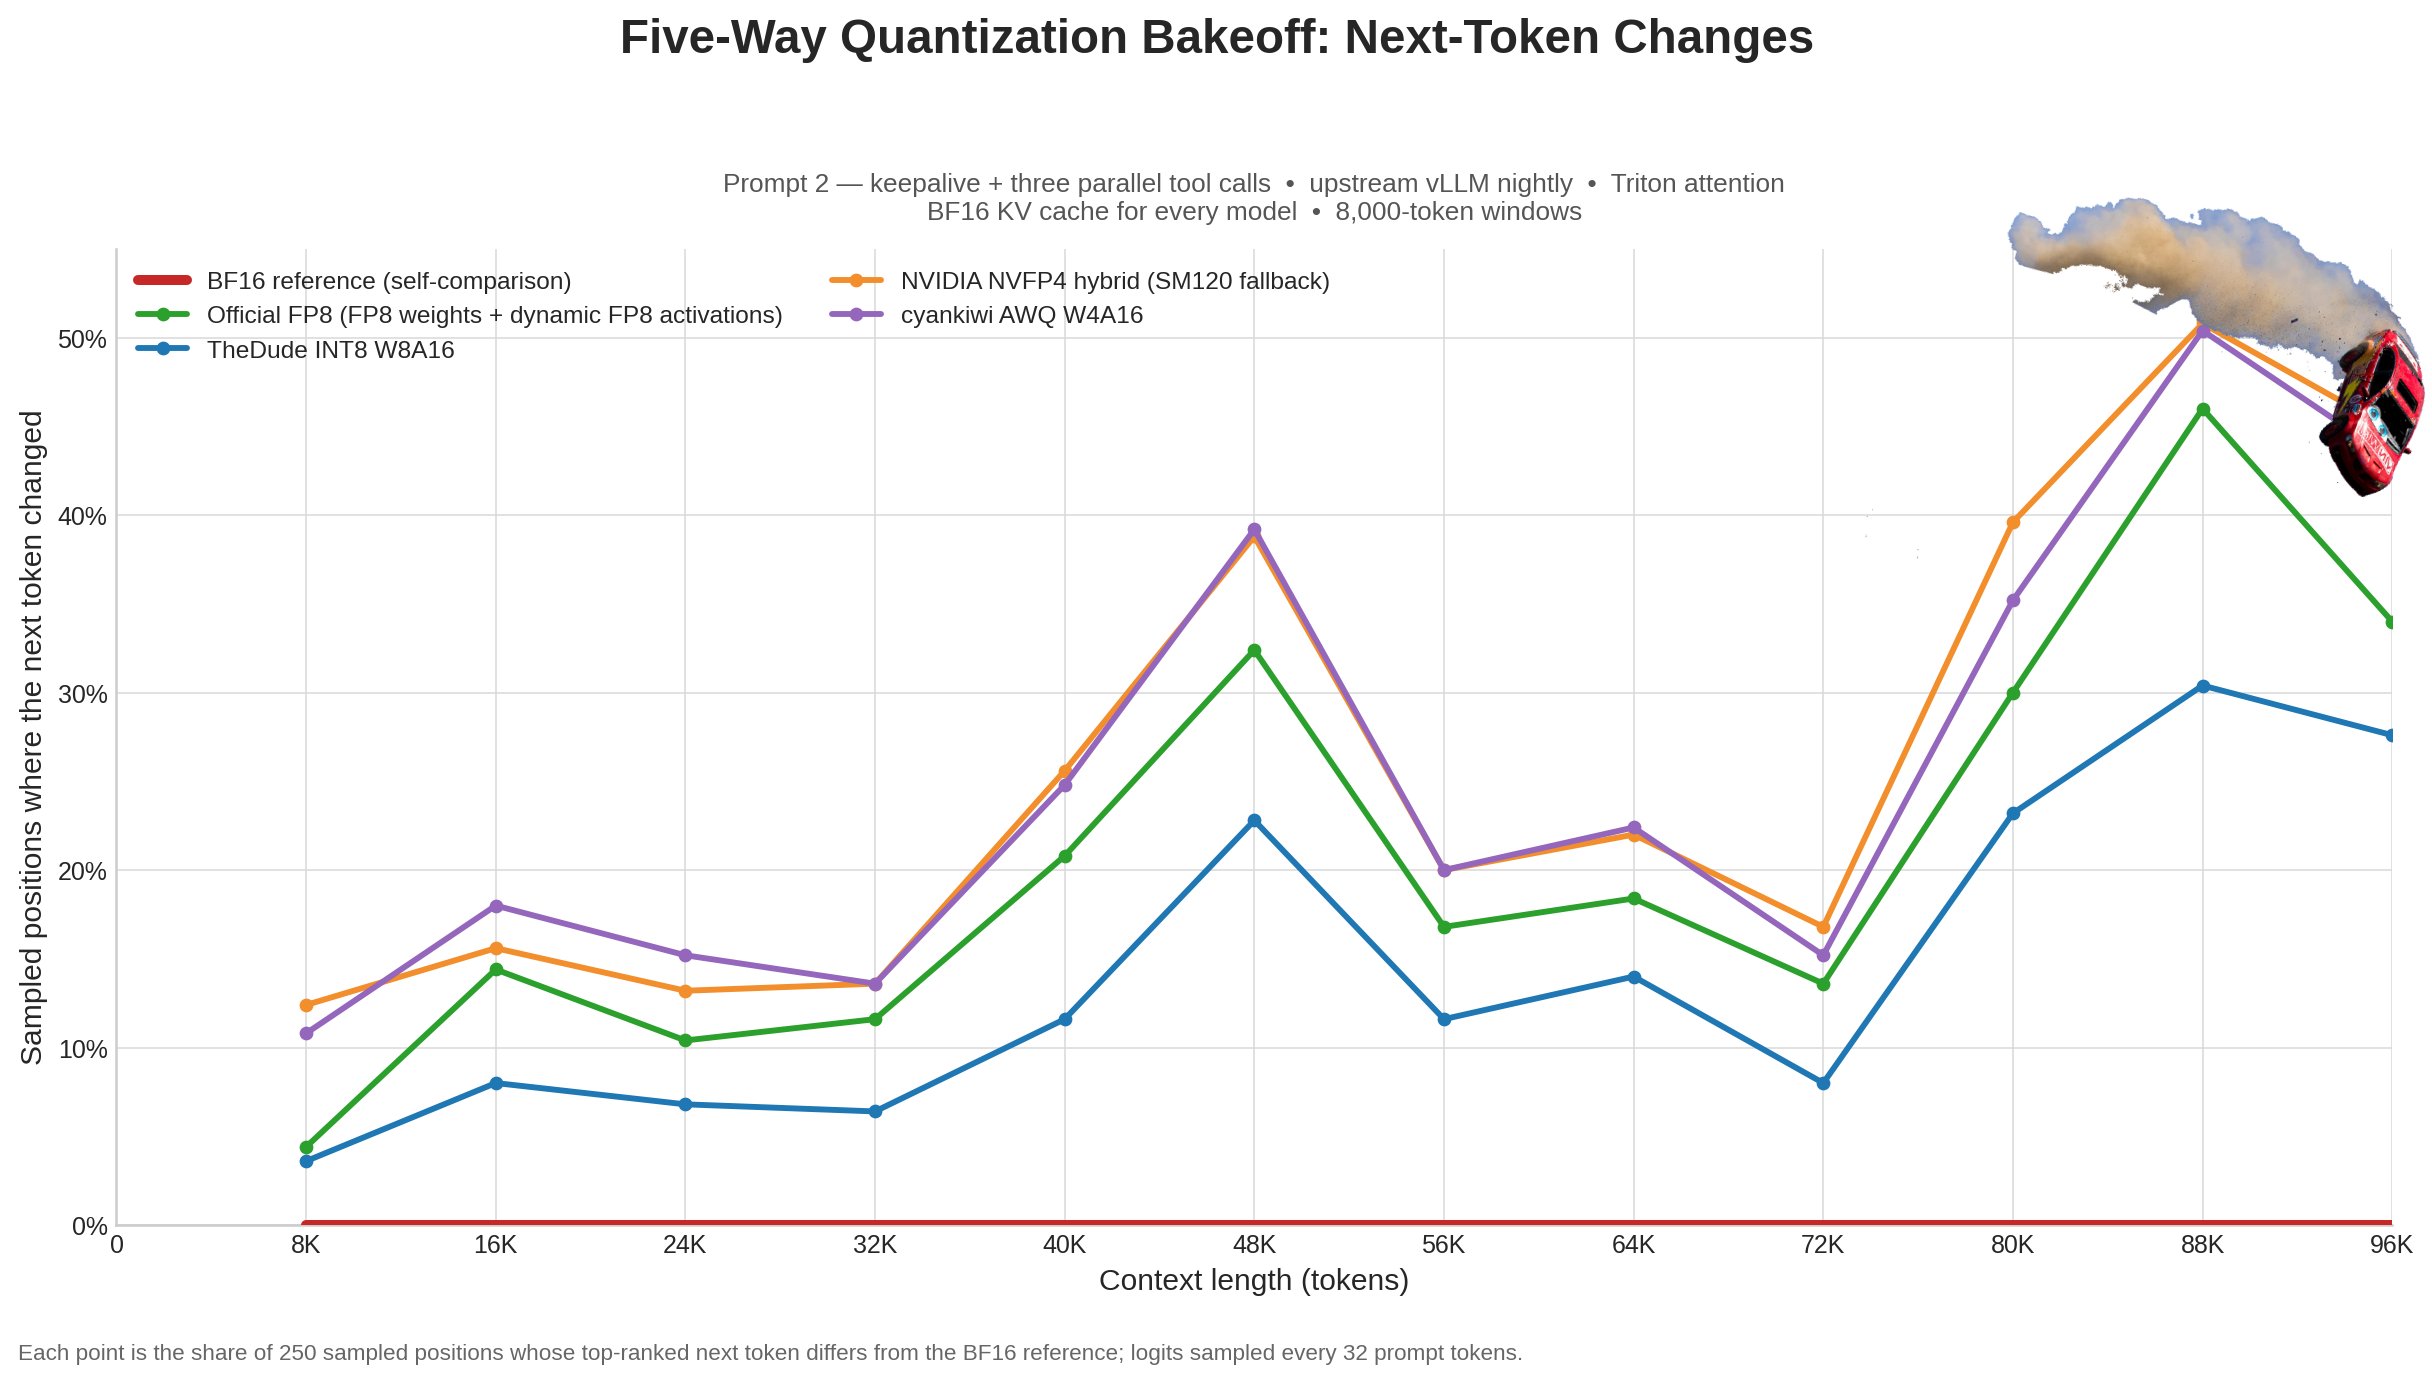
同一份模型权重,在官方演示里对答如流,部署到本地却频繁表现失常:长上下文读到后半段输出开始漂移,量化版本连工具调用都闭合不了。Level1Techs 论坛上一篇带完整数据的受控实验《Why your local LLM feels dumber than it is》把原因指向了推理软件栈:从注意力算子到量化 kernel,每一层都在改变下一个 token…
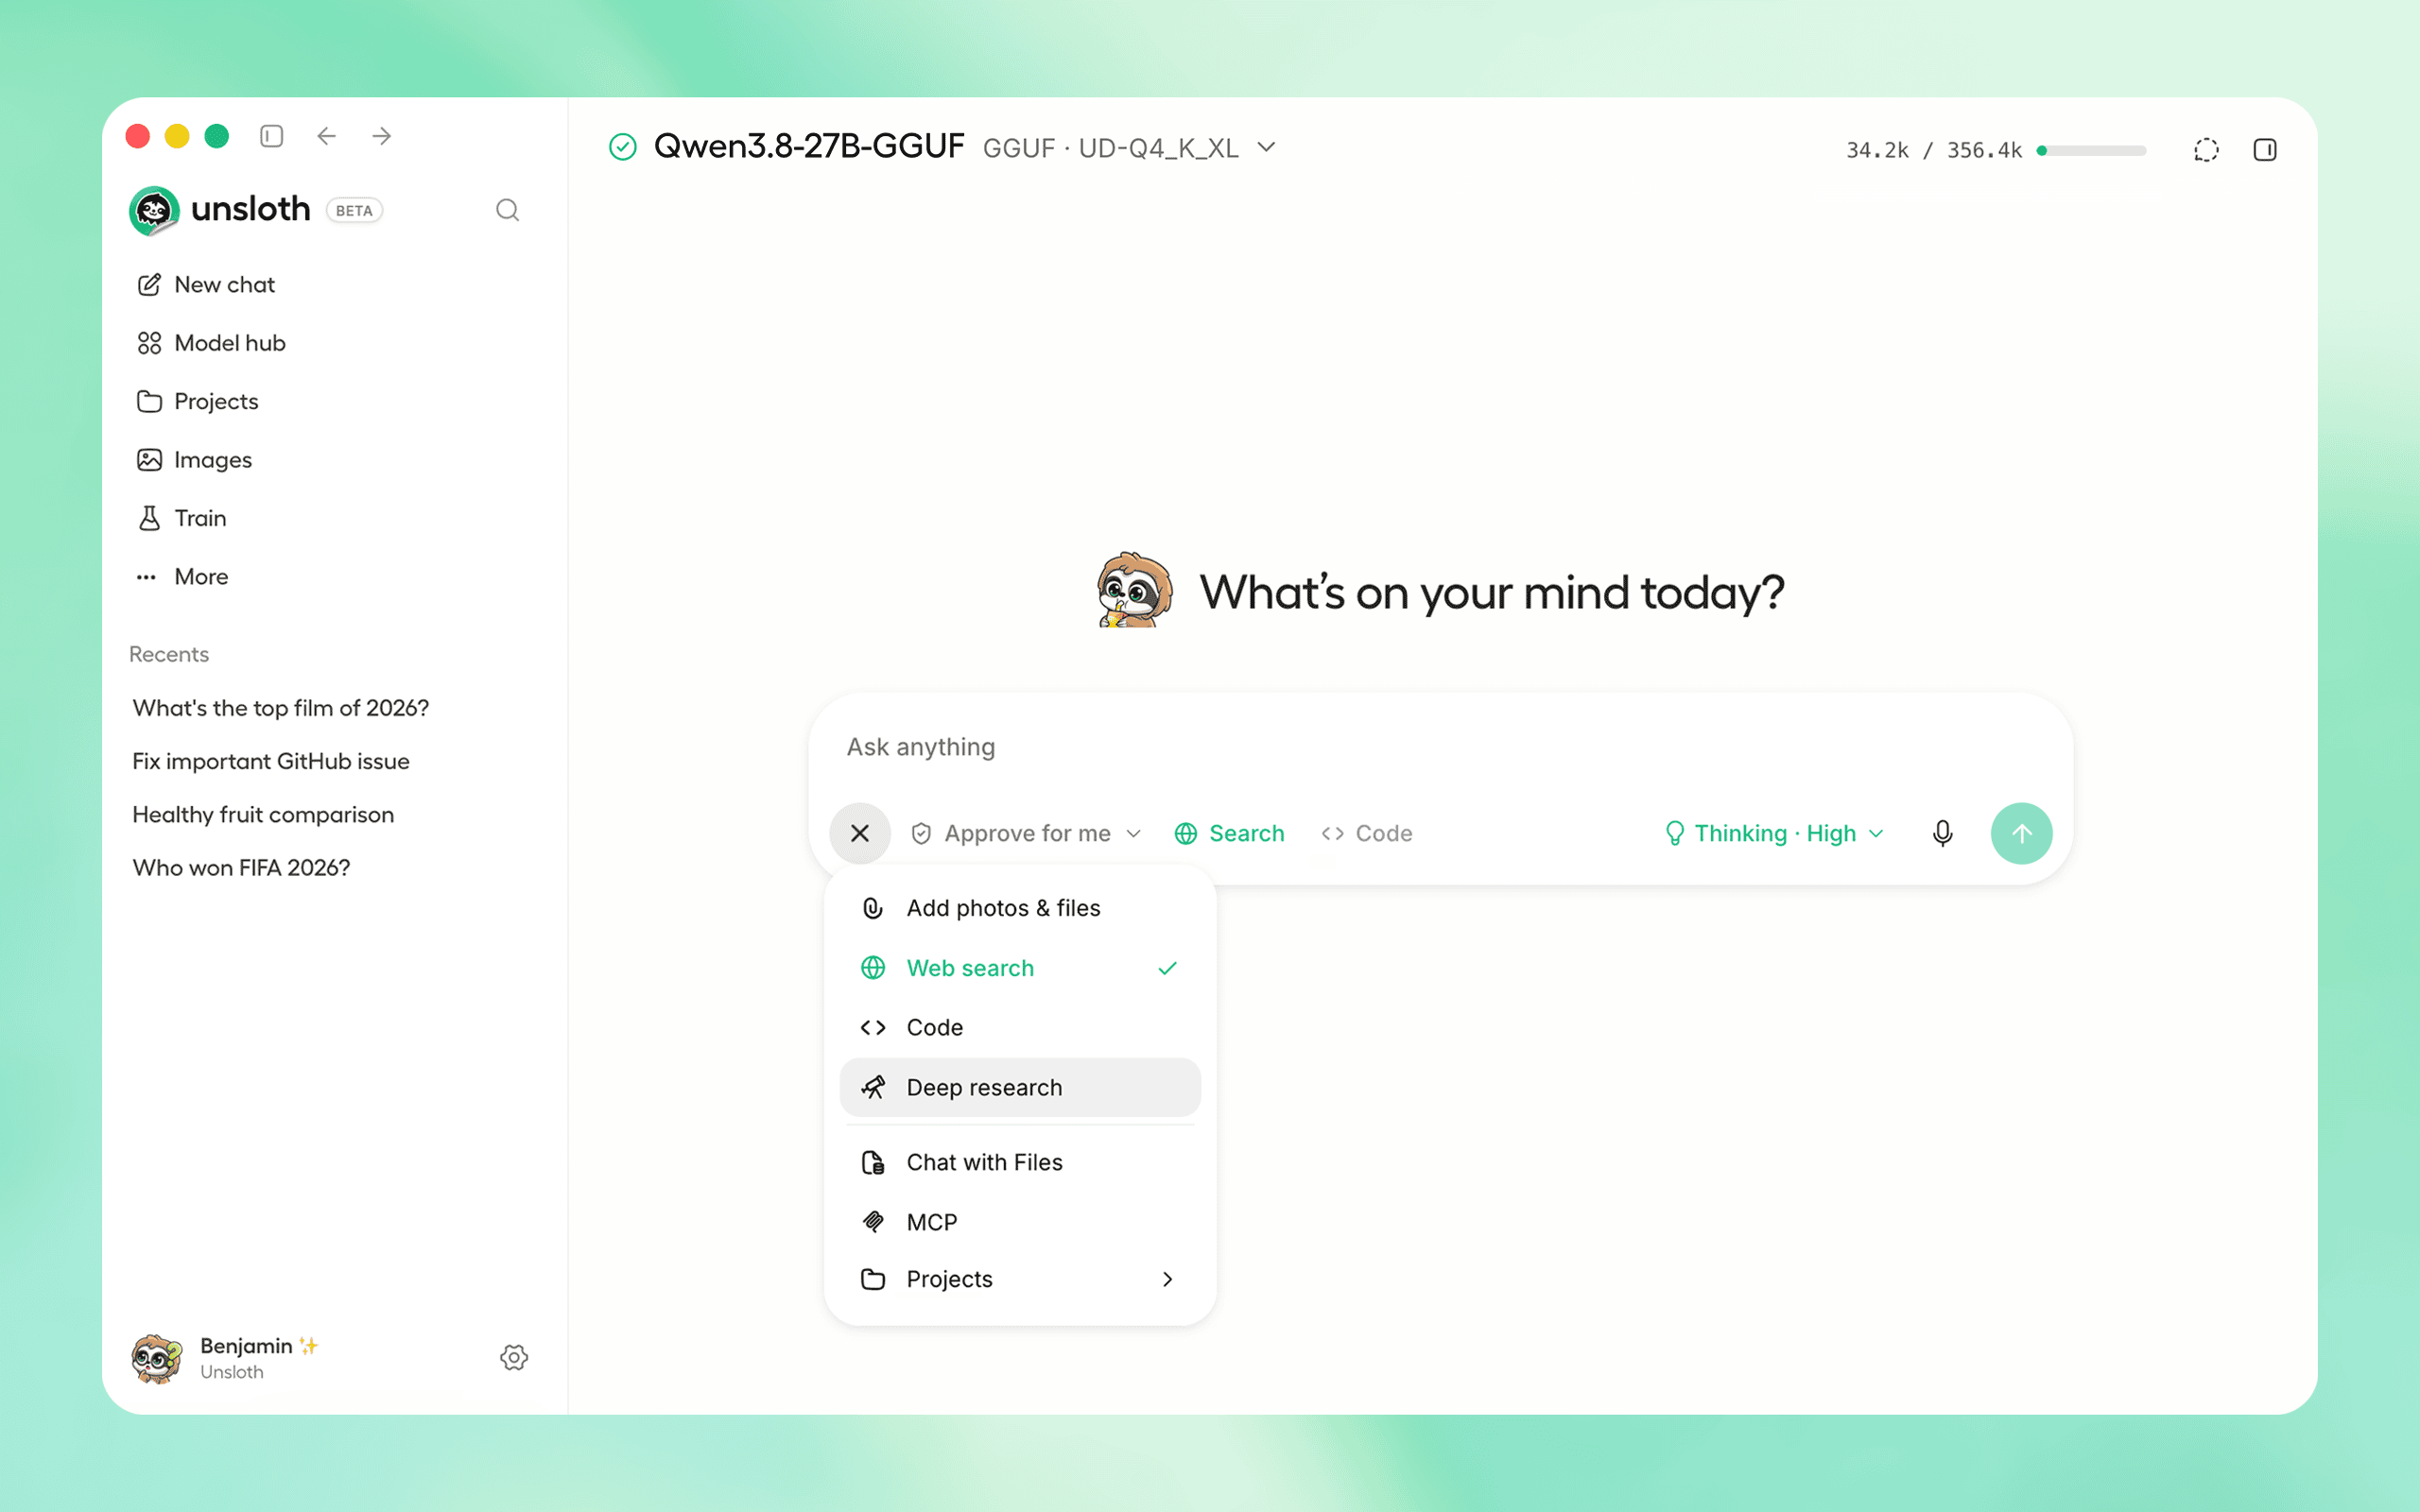
从命令行到桌面应用:Unsloth 如何把本地 AI 推向"开箱即用" 2026 年 8 月 11 日,Unsloth 团队发布了 Unsloth Desktop,一个基于 Tauri 框架构建的原生桌面应用,声称是"第一款能运行和训练模型的桌面应用"。对于一直在用 Python 脚本和命令行折腾 Unsloth 核心库的开发者来说,这次发布标志着这个项目从…
Muse Glimmer 2026 年 8 月 10 日,Meta 超级智能实验室(Meta Superintelligence Labs)发布 Muse Glimmer,一款拥有 300 亿参数的稠密语言模型。模型权重以 Apache 2.0 许可证开放,目前已在 Hugging Face 提供下载。 Muse Glimmer 的定位很明确:面向本地智能体…
大模型量化详解:从 FP16 到 Q4KM 该怎么选 本地部署大模型时,你一定会遇到一个问题:该下哪个版本?HuggingFace 上同一个模型往往有十几个文件——Q4KM、Q5KS、Q80、FP16……它们之间到底差多少?选错了要么跑不动,要么浪费内存。 这篇文章把量化的原理、各级别的真实区别、以及不同硬件该怎么选一次讲清楚。 量化在做什么 一个训练好的模…