VoiceStudio:本地开源语音工作台拆解,OmniVoice 引擎让 600 种语言 40 倍速克隆声音
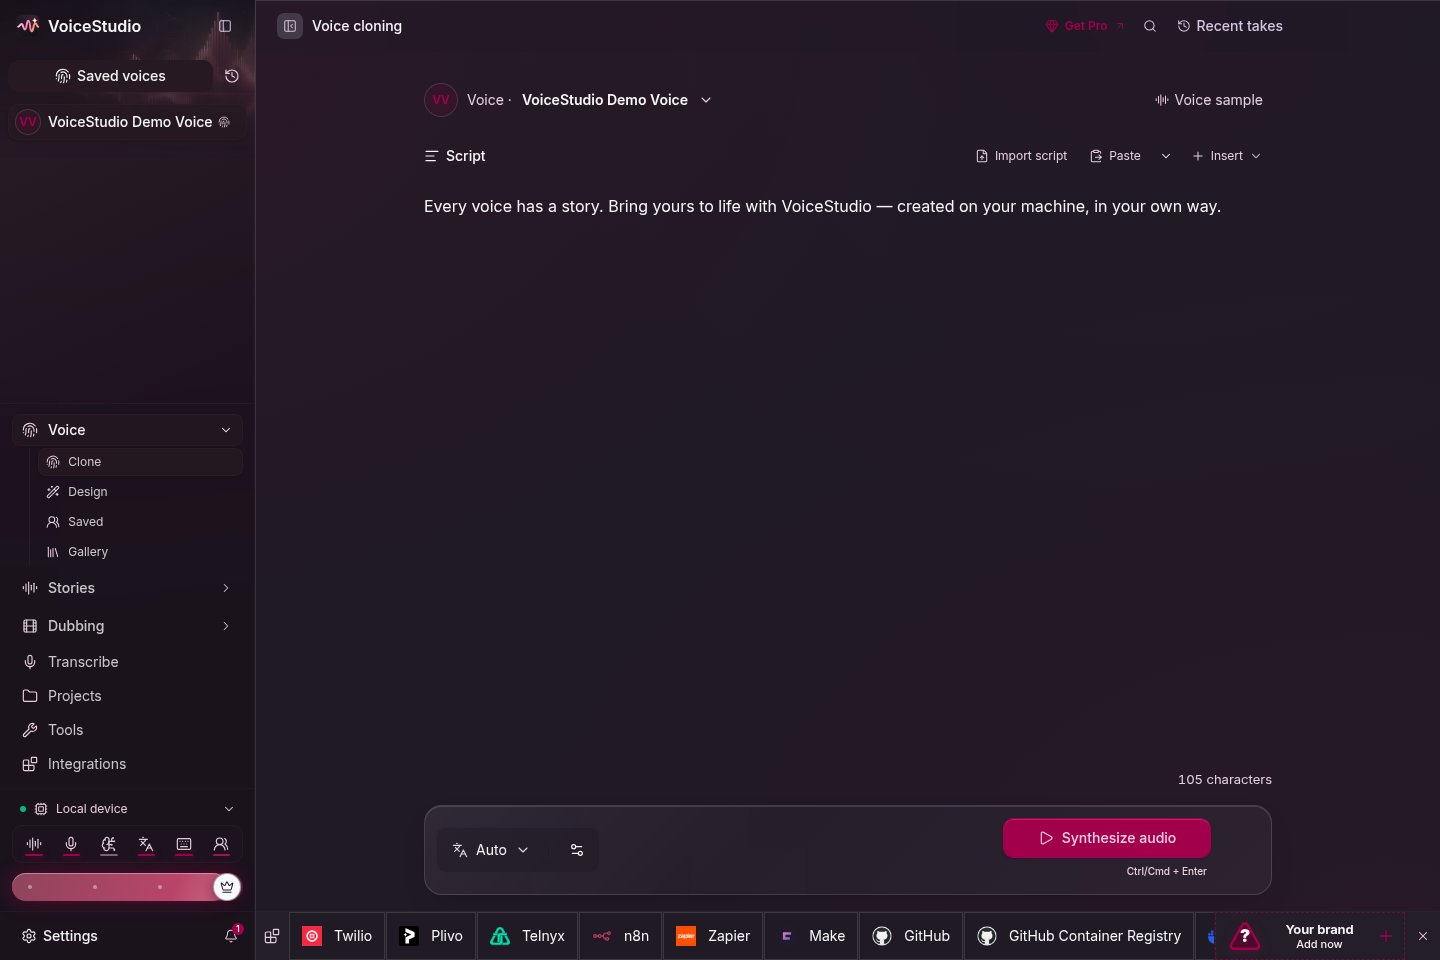
一个 2026 年 4 月才创建的 GitHub 仓库,现在每天还在以两千多 star 的速度增长。VoiceStudio 是一个完全本地运行的语音工作台:克隆声音、按文字描述设计声音、给视频配音、录音转文字、批量产出有声书,全部在自己机器上完成,不依赖任何云端 API。它 73,225 个 star 的背后,有一个常被忽略的技术事实:真正干活的引擎是 k2…
一个 2026 年 4 月才创建的 GitHub 仓库,现在每天还在以两千多 star 的速度增长。VoiceStudio 是一个完全本地运行的语音工作台:克隆声音、按文字描述设计声音、给视频配音、录音转文字、批量产出有声书,全部在自己机器上完成,不依赖任何云端 API。它 73,225 个 star 的背后,有一个常被忽略的技术事实:真正干活的引擎是 k2…
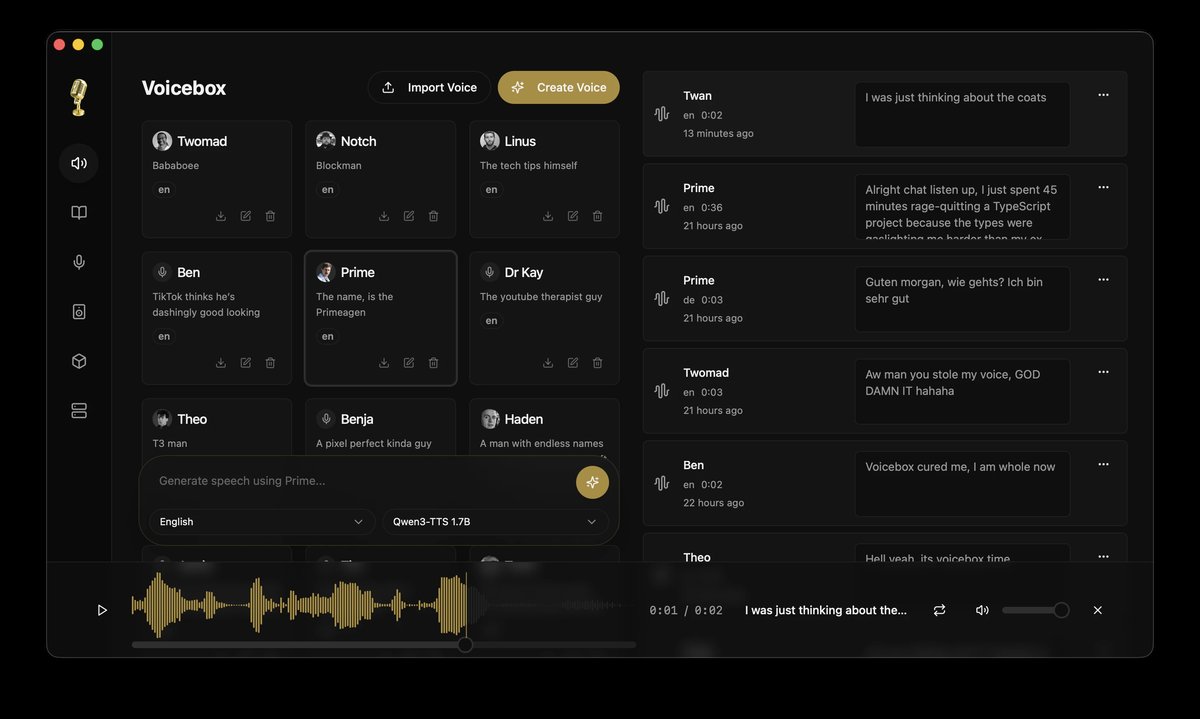
Voicebox:一个开源项目把 ElevenLabs 和 WisprFlow 的活都干了 当 AI 语音工具的市场被两家公司分占时——ElevenLabs 主导语音合成输出,WisprFlow 主导语音听写输入——一个名为 Voicebox 的开源项目正在尝试同时覆盖这两端,并且把整套流程跑在你自己的机器上。 Voicebox 由开发者 Jamie Pin…