标签: 多模态
清除筛选
LensVLM-9B 技术解读:Apple 把长文档压成图片给 AI 读,4.3 倍压缩不掉点
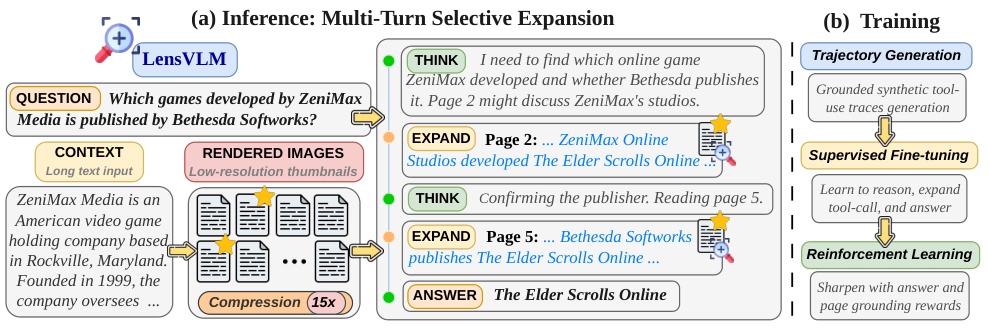
9 月 22 日,Hacker News 上一个标题拿到 393 分热度:「Claude discovers a novel enzyme system」。点进去会发现链接指向的是 Apple 在 Hugging Face 上新放出的模型权重:LensVLM-9B。这个时间点适合作一个参照:同一个 9B 视觉语言模型(Vision Language Mode…
FLUX 3:Black Forest Labs 的多模态模型与机器人野心
2026 年 7 月 23 日,Black Forest Labs(BFL)发布了 FLUX 3,这是这家德国 AI 实验室首个多模态基础模型。FLUX 3 将图像、视频和音频的训练统一到同一架构下,并能扩展到机器人动作预测。视频能力是这次发布的核心:单个提示词可生成最长 20 秒、带原生音频的 720p 视频片段。 FLUX 3 目前处于 Early Ac…
字节跳动开源 Lance:3B 参数统一图像视频理解生成与编辑
字节跳动发布 Lance,一个仅 3B 激活参数的轻量级原生统一多模态模型,在单一框架下同时支持图像理解、视频理解、图像生成、视频生成和跨模态编辑五种任务。模型使用 Apache 2.0 许可,权重已在 Hugging Face 开放。 Lance 模型概览 
DeepSeek 发布视觉基元推理报告,用点和框解决多模态 Reference Gap
2026 年 4 月 30 日,DeepSeek 公开技术报告《Thinking with Visual Primitives》,提出一种新的多模态推理范式——将点(point)和框(bounding box)等视觉基元作为思维的最小单元,交错嵌入推理链中。 问题:Reference Gap 当前多模态大模型虽然在「感知差距」(Perception Gap)…
NVIDIA Nemotron 3 Nano Omni:一个开放模型统一视觉、音频和语言
NVIDIA Nemotron 3 Nano Omni:一个开放模型统一视觉、音频和语言 4 月 28 日,NVIDIA 发布 Nemotron 3 Nano Omni,一个开放权重的全模态理解模型,将视觉、音频和语言处理统一到单一架构中。模型采用 30B-A3B 混合专家(MoE)架构,总参数 300 亿,每个 token 仅激活 35 亿参数,支持 25…
智谱GLM-5V-Turbo:首款原生多模态编程基础模型
4月2日,智谱AI(Z.ai)发布GLM-5V-Turbo,首款原生多模态编程基础模型。模型原生支持图像、视频、文本等多模态输入,上下文窗口200K,最大输出128K tokens。 模型定位 GLM-5V-Turbo的定位很明确:一个"看得见、写得出"的编程模型。它不是在文本模型上嫁接视觉能力,而是从预训练阶段就做多模态融合,CogViT视觉编码器与MTP…