Whistle 语音识别模型拆解:16.9 MB 单文件,CPU 跑出 11ms 首 token,与 Needle 共用引擎
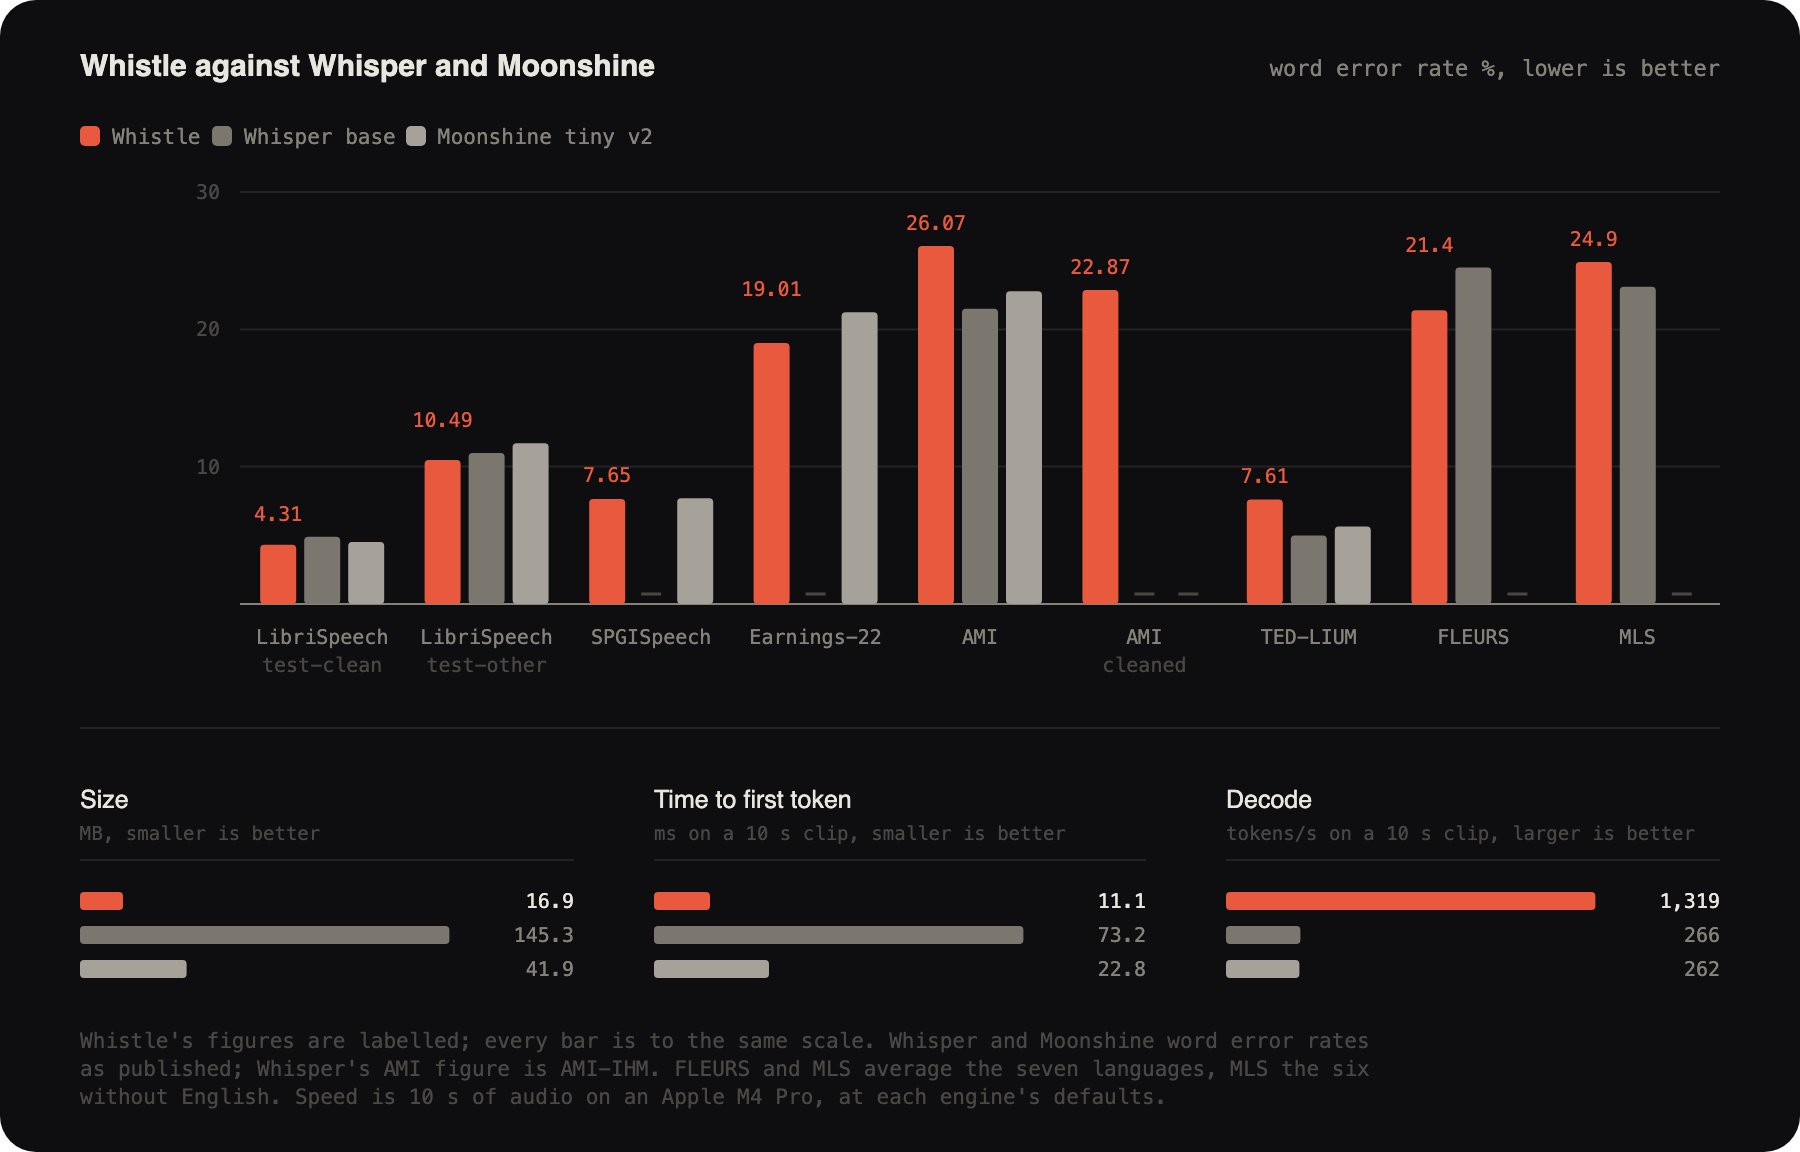
Whistle:一个 16.9 MB 的文件,把语音识别塞进 30 秒音频和 11 毫秒首 token 端侧语音识别的常规剧本是把参数更大的模型量化压缩,再接受精度打折。Cactus Compute 这次给出的样本走的是另一条路:Whistle 是一个 Apache 2.0 协议的开放权重语音识别模型,整个模型就是单个 16.9 MB 的 .cact 文件,…
Whistle:一个 16.9 MB 的文件,把语音识别塞进 30 秒音频和 11 毫秒首 token 端侧语音识别的常规剧本是把参数更大的模型量化压缩,再接受精度打折。Cactus Compute 这次给出的样本走的是另一条路:Whistle 是一个 Apache 2.0 协议的开放权重语音识别模型,整个模型就是单个 16.9 MB 的 .cact 文件,…
2026 年 7 月 23 日,微软研究院发布了 VibeVoice-ASR-BitNet,将原本需要 GPU 运行的 7B 参数语音识别模型压缩到 1.58 GB,在普通 CPU 上实现了实时识别(RTF < 1),速度达到 Whisper.cpp 的 1.6 到 2.3 倍。 这是 VibeVoice 开源语音 AI 框架的最新一环。VibeVoice…
本地语音转文字的开发者,长期以来面对一个尴尬的现实:能用的推理栈屈指可数。OpenAI 的 Whisper 有官方 Python 实现和社区维护的 whisper.cpp,NVIDIA 的 Parakeet 和 Canary 必须跑在笨重的 NeMo PyTorch 框架上,想上 GPU 加速还要自己折腾 ONNX 转换。每换一个模型家族,就要重写一遍部署管…