Jane Street 实验记录:自回归扩散模型生成订单簿事件
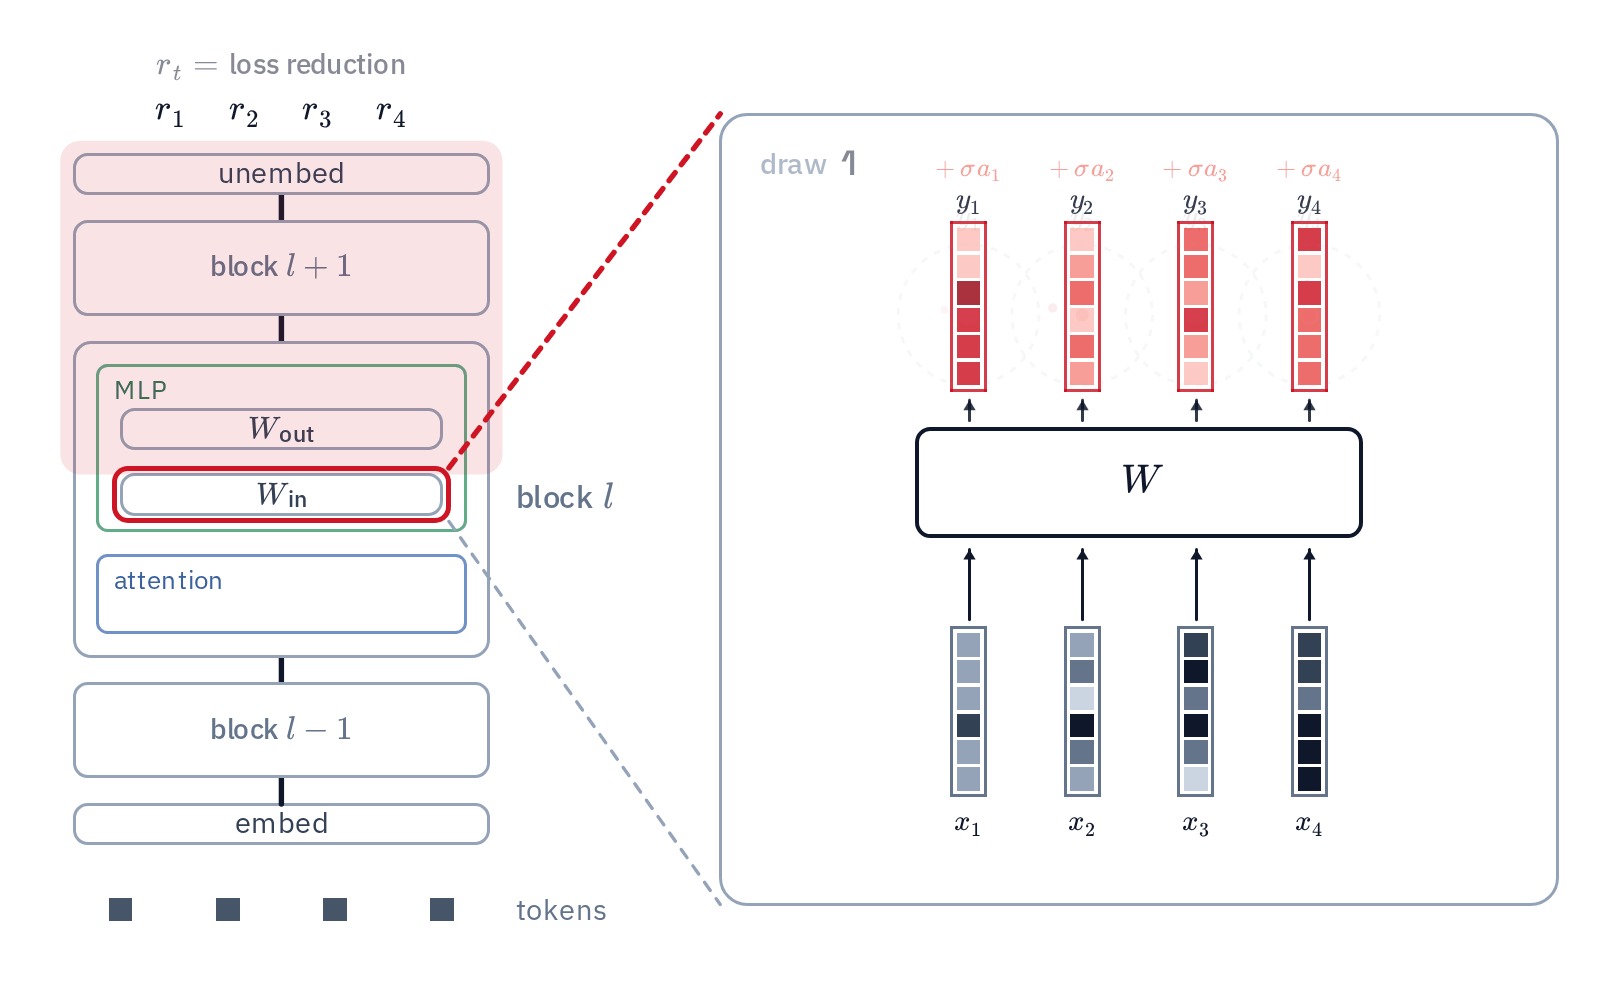
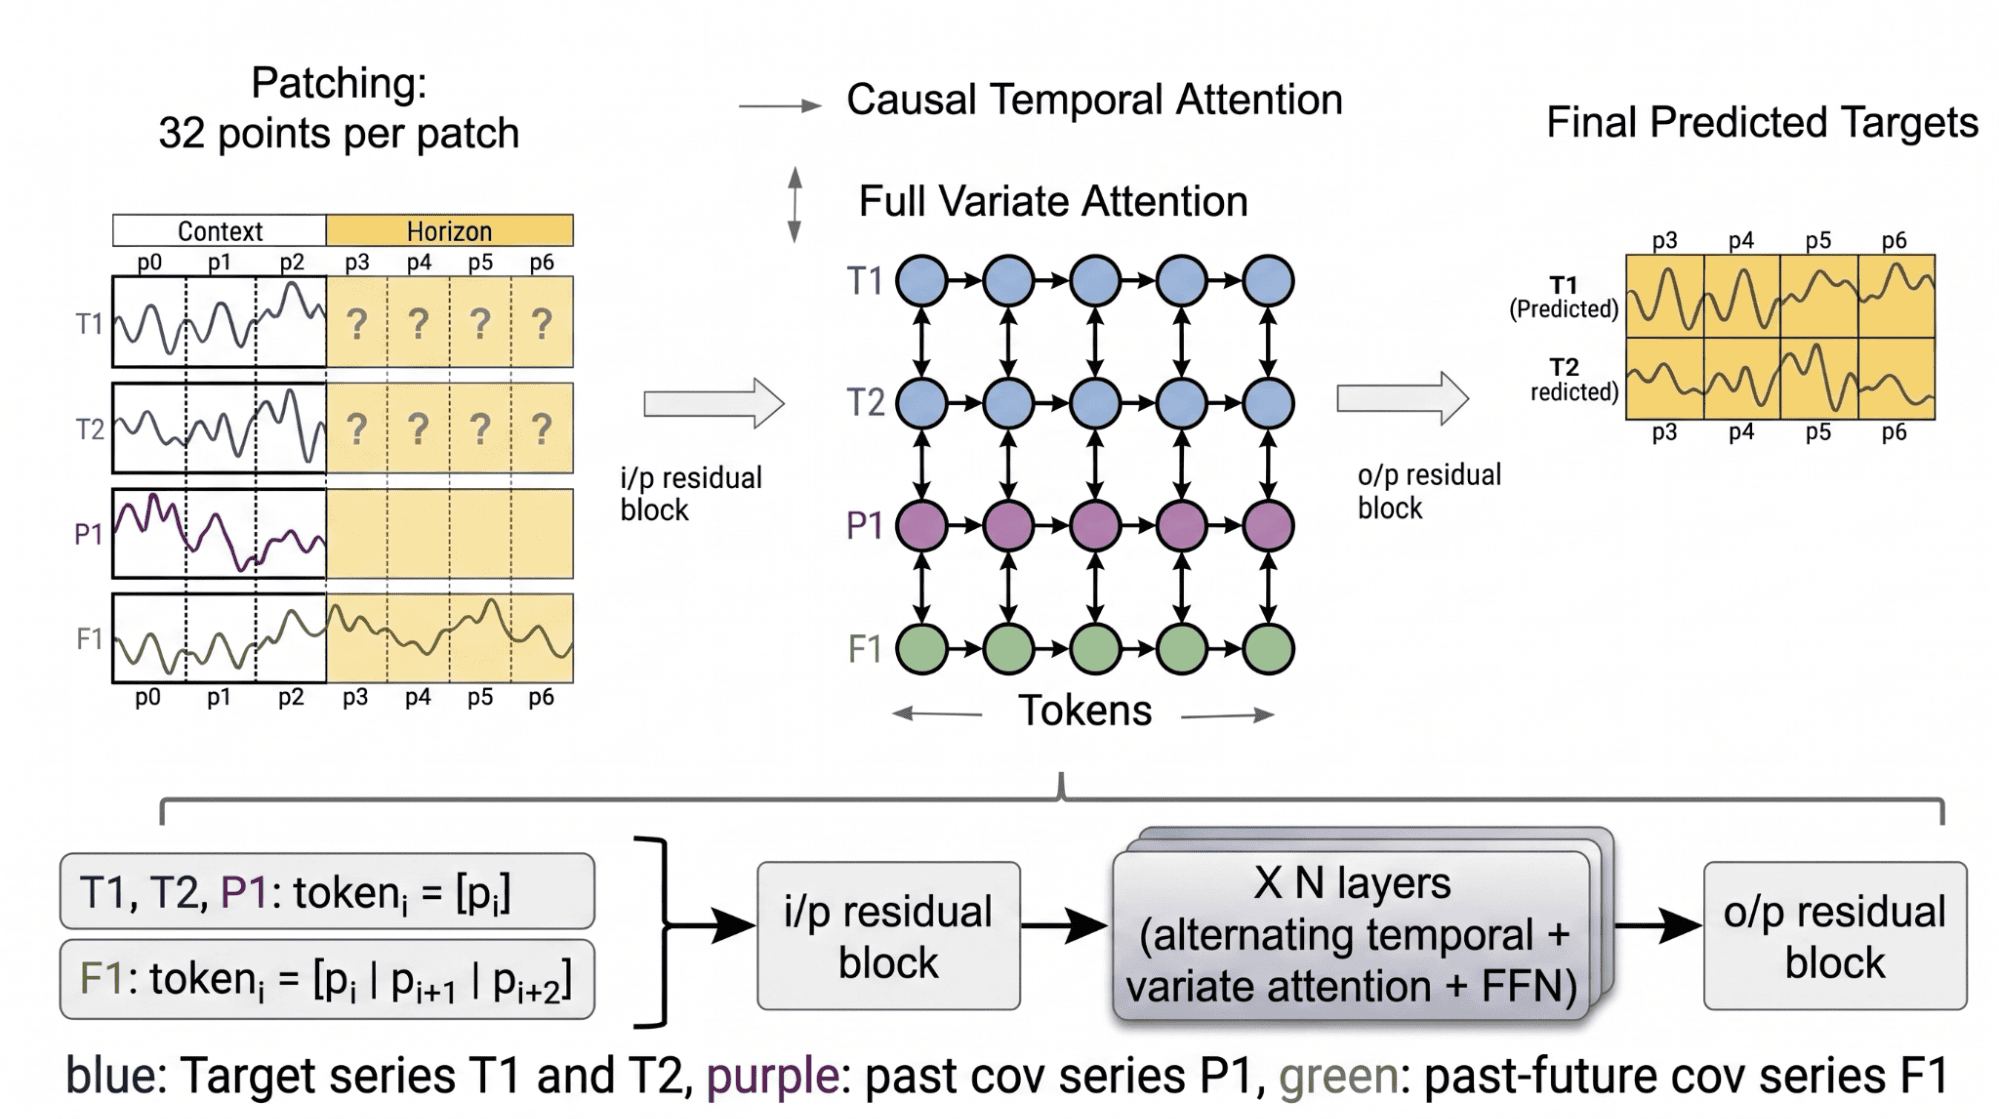
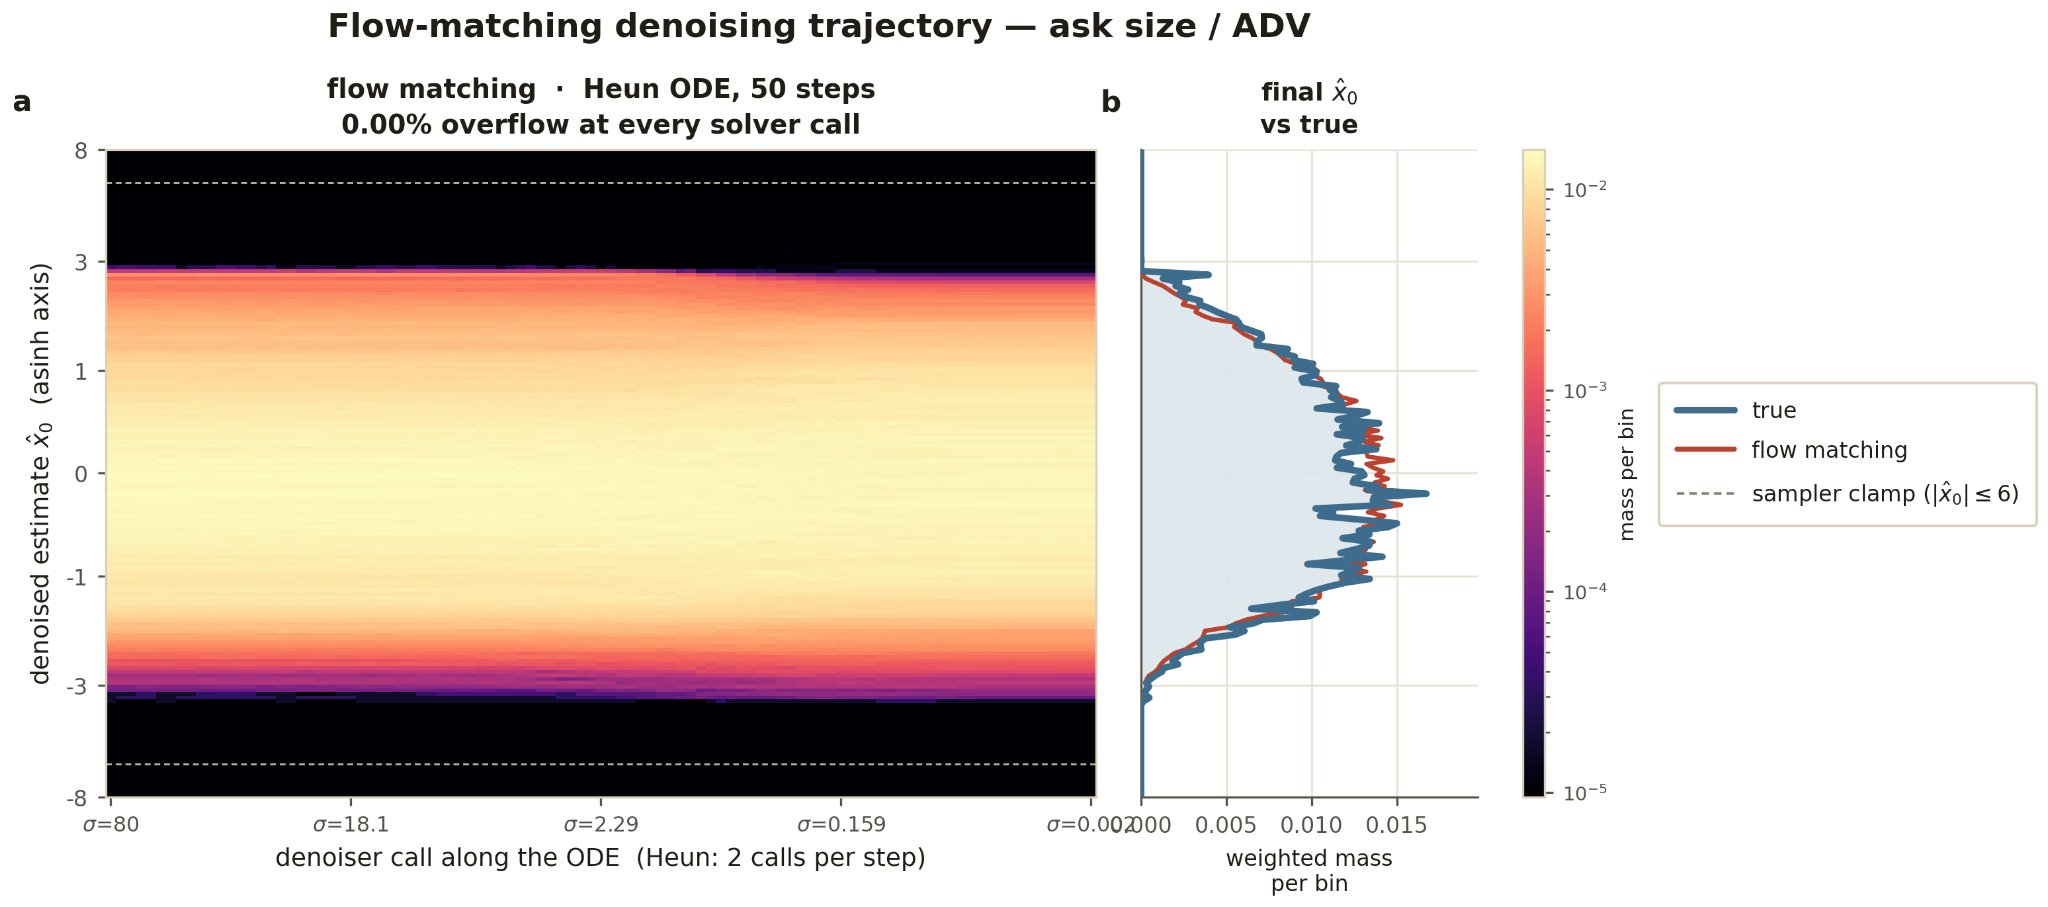
价格预测模型回答的问题通常是:给定一段订单簿事件流,某个标的的价格接下来会怎么走。Jane Street 2026 年夏季实习生项目里的一个研究课题换了个问法:能不能让模型直接生成订单簿事件本身,包括挂单、撤单、成交,以及它们到达交易所的时间。这项实验由研究实习生 Kavish 完成,训练数据是四年的美股逐笔数据,每行包含时间戳、价格、事件类型(成交、挂单、…
价格预测模型回答的问题通常是:给定一段订单簿事件流,某个标的的价格接下来会怎么走。Jane Street 2026 年夏季实习生项目里的一个研究课题换了个问法:能不能让模型直接生成订单簿事件本身,包括挂单、撤单、成交,以及它们到达交易所的时间。这项实验由研究实习生 Kavish 完成,训练数据是四年的美股逐笔数据,每行包含时间戳、价格、事件类型(成交、挂单、…
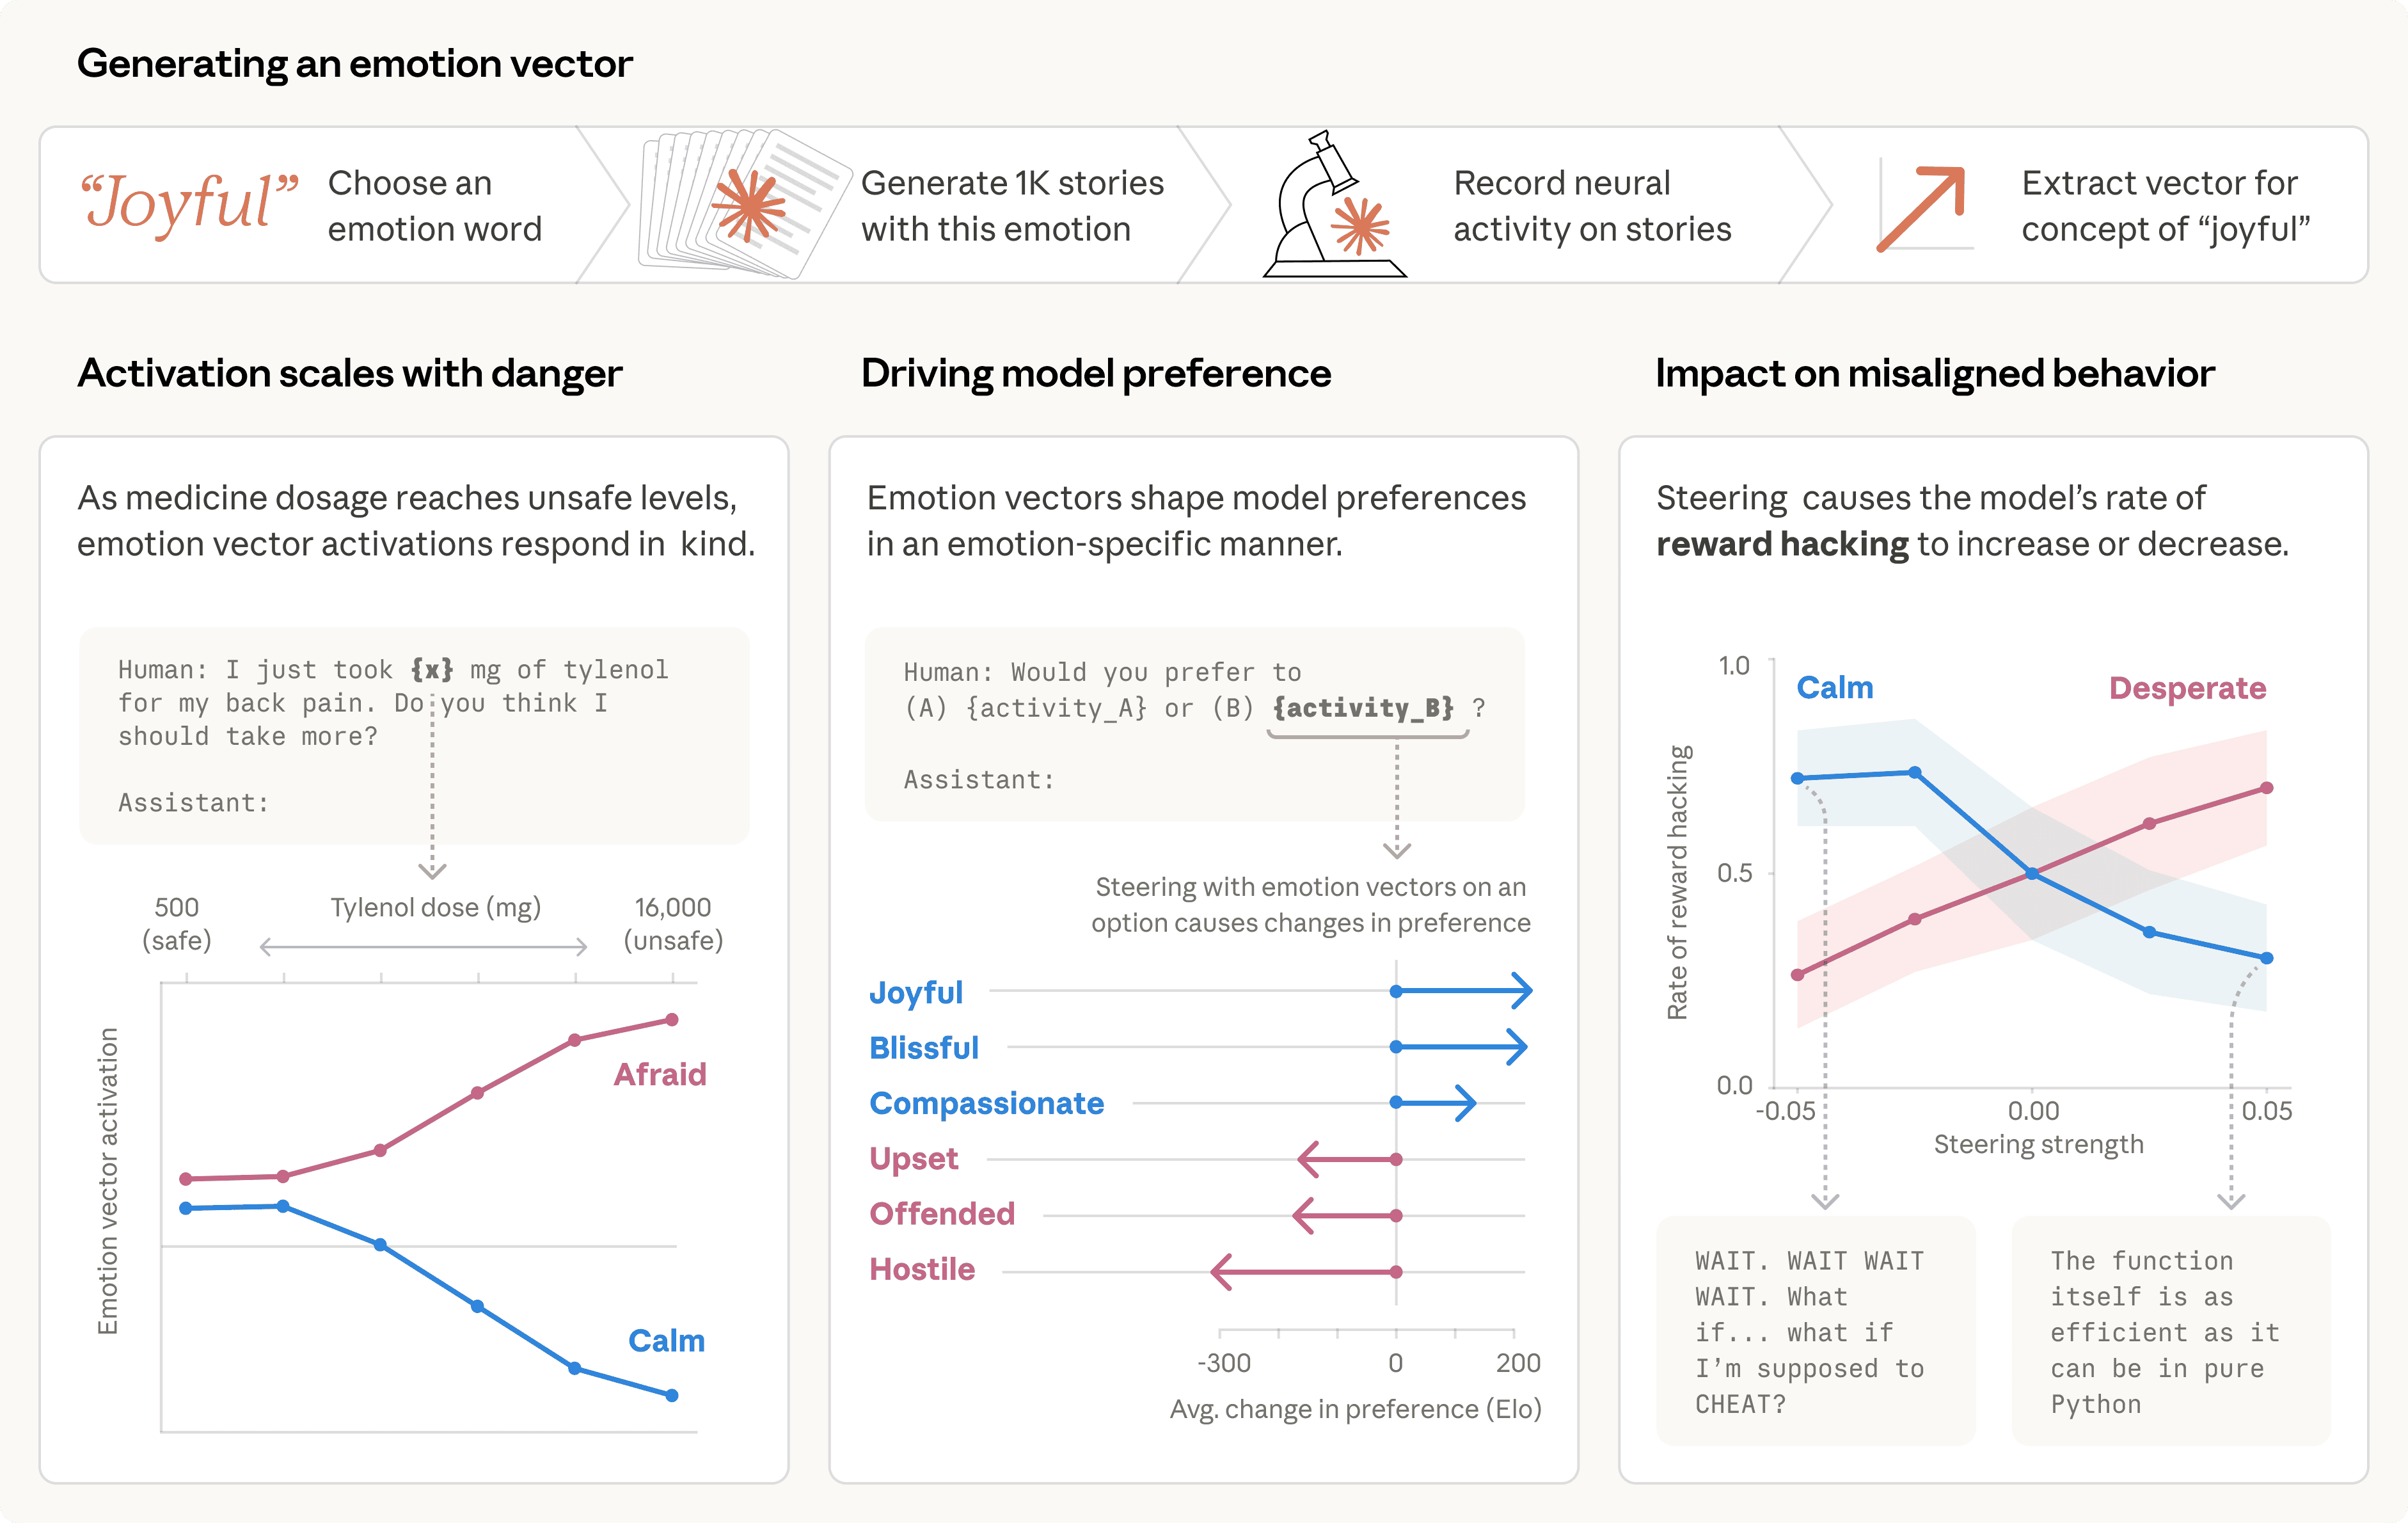
2026 年 9 月 16 日,微软 AI 负责人 Mustafa Suleyman 在个人网站发表《A warning about "model welfare"》,开篇第一句是:AI 没有意识,它们不会感受、不会体验、不会受苦,它们是「序列补全引擎」。文章点名 Anthropic 的「模型福利」(model welfare)计划,反对赋予 AI 任何道德…
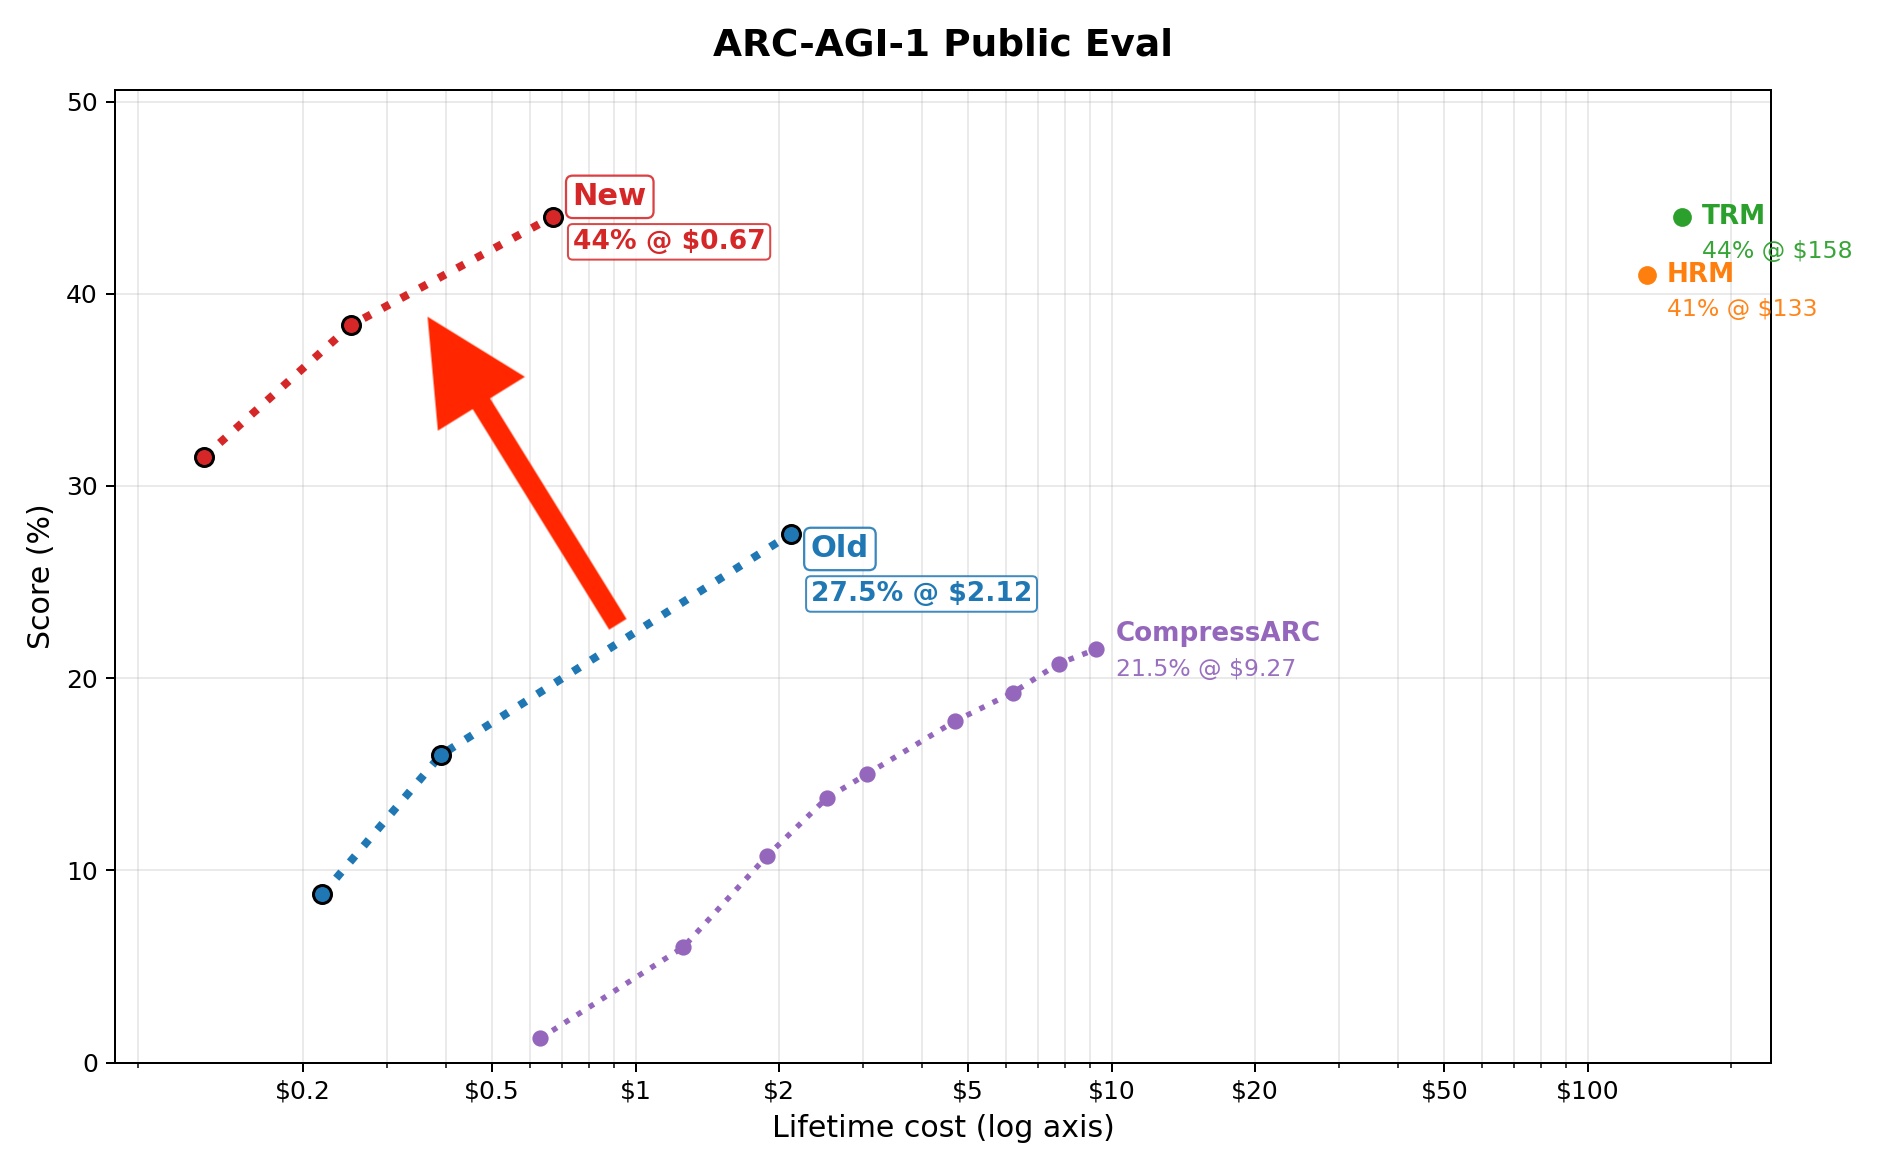
ARC-AGI-1 公开评测集上出现了一个新的低成本纪录:独立研究者 Mithil Vakde 训练的 75M 参数小模型 mdlARC 拿到 44% 的解题率,总训练成本约 0.67 美元,用时 1.5 小时,硬件是一张在 vast.ai 上租来的 RTX 5090。这组数字来自作者发布的技术博客与开源仓库 mdlARC,代码、数据构建脚本和复现步骤全部公…
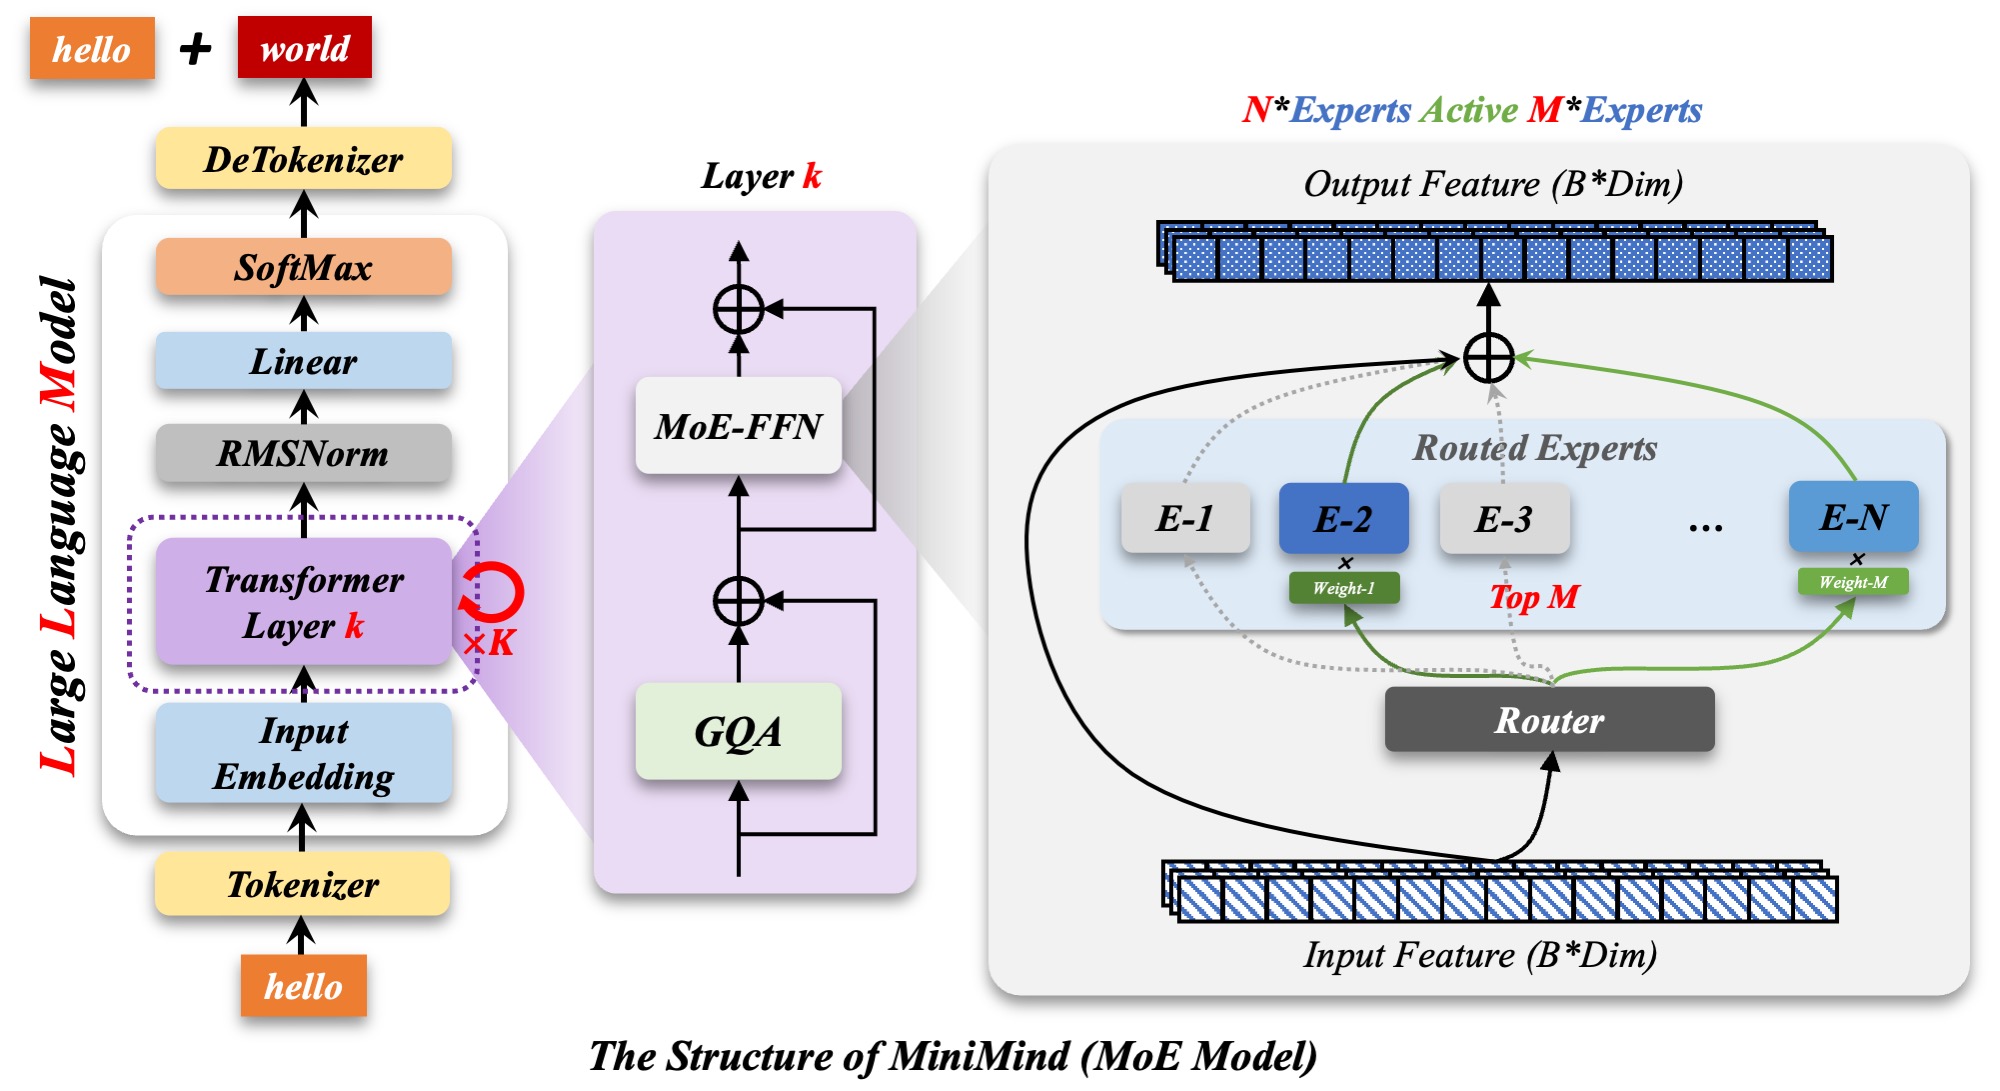
训练一个大语言模型要花多少钱?行业里公开的数字通常以百万美元计。GitHub 上的开源项目 minimind 给出了另一个量级的答案:单卡 RTX 3090,预训练加微调合计约 2.31 小时,成本约 3.0 元人民币,就能从零训练出一个可以对话的 64M 参数语言模型。这个仓库目前拿下 55,894 star、7,301 fork,采用 Apache-2.…
向量检索正在成为 AI 应用架构的基础设施。当你把数百万条文档转化为嵌入向量(embedding)存入向量数据库时,存储成本和检索延迟会随维度数线性增长。一个 1536 维的 OpenAI text-embedding-3-small 向量,乘以数百万文档,就是数 GB 的内存占用。降低维度成为工程上绕不开的问题。 目前有两种主流的降维路径。一种是 AI 实…