Qwen3.8 发布:2.4T 参数、原生多模态、开放权重承诺
Qwen 3.8 神经网络可视化 7 月 19 日,阿里巴巴通义千问(Qwen)团队在 X 平台发布 Qwen3.8,宣称参数规模达到 2.4 万亿(2.4T),并承诺将开放权重(open-weight)。这是 Qwen 家族首次有模型突破万亿参数门槛并具备原生多模态能力。Qwen 团队将其定位为"仅次于 Anthropic Fable 5 的最强模型"。…
Qwen 3.8 神经网络可视化 7 月 19 日,阿里巴巴通义千问(Qwen)团队在 X 平台发布 Qwen3.8,宣称参数规模达到 2.4 万亿(2.4T),并承诺将开放权重(open-weight)。这是 Qwen 家族首次有模型突破万亿参数门槛并具备原生多模态能力。Qwen 团队将其定位为"仅次于 Anthropic Fable 5 的最强模型"。…
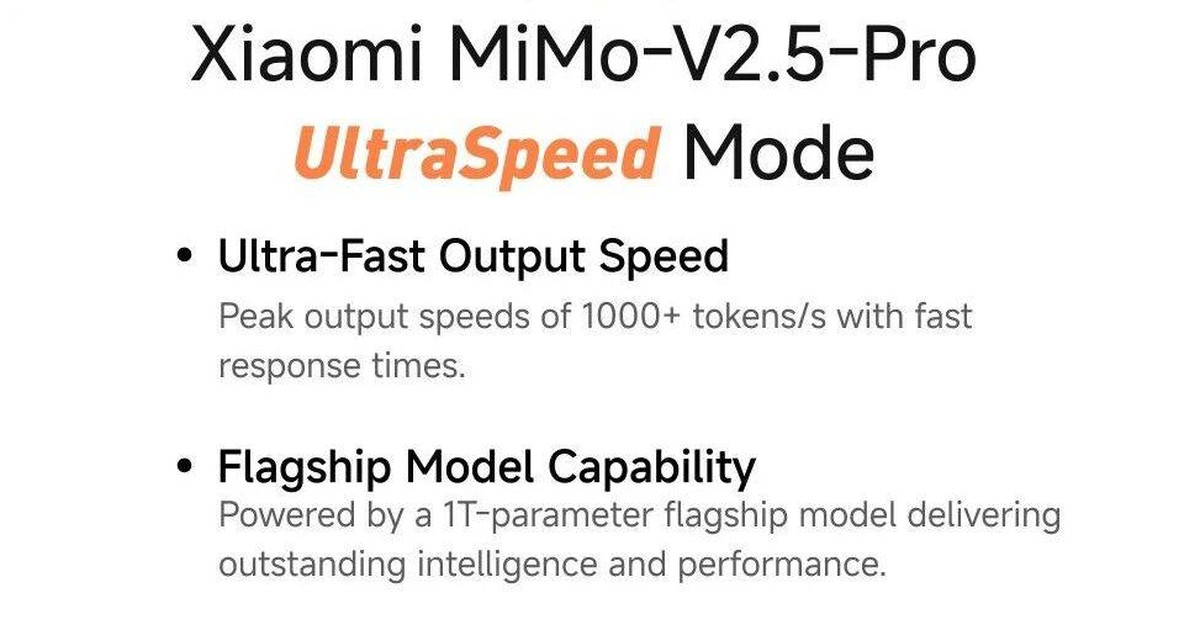
推理速度:大模型竞争的下一个主战场 2026年,大模型竞赛正进入一个新维度。从高频量化交易到实时风控,从多Agent协同推理到自动驾驶决策,越来越多对延迟极度敏感的场景开始要求模型不仅"够聪明",更要"够快"。GPT-5.5的68 tokens/s、Claude的71 tokens/s,在传统文本生成场景中或许够用,但在毫秒级决策窗口的工业场景下,这些数字远…
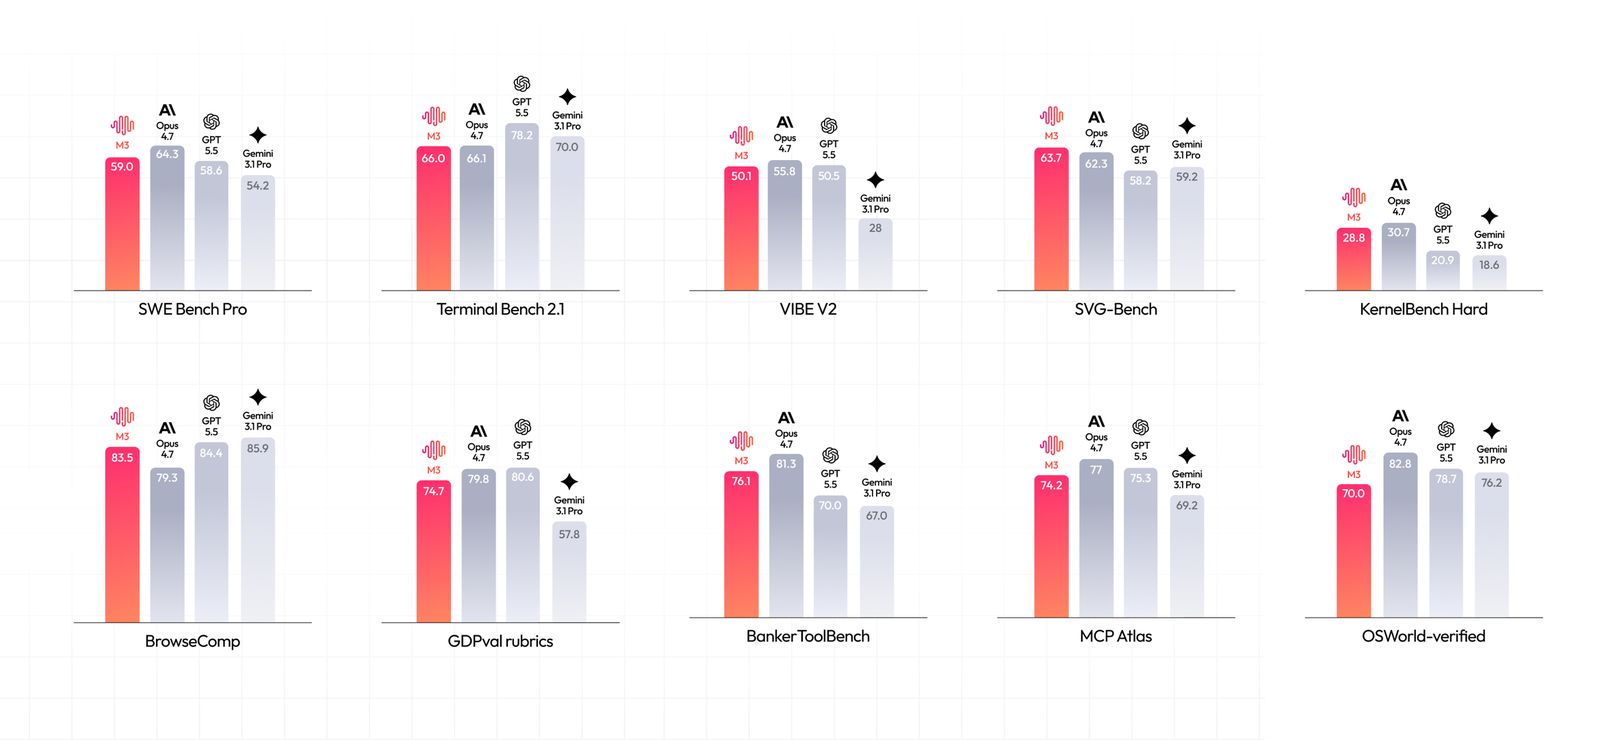
MiniMax M3 Benchmark MiniMax 今日正式发布 M3 模型。这是一个同时具备前沿 Coding 能力、百万级上下文和原生多模态的模型——国内第一个,也是目前全球唯一达成这一配置的开源模型。 M3 采用 MiniMax 自研的 MSA(MiniMax Sparse Attention)稀疏注意力架构,最高支持 1M 上下文窗口。在 10…
DeepSeek 今日正式发布 V4 系列模型预览版,同步开源。两个版本——V4-Pro 和 V4-Flash——均支持 1M 上下文长度,并在 Agent 能力上进行了专项优化。 V4-Pro 与顶级闭源模型评测对比 两个版本,两个定位 V4-Pro 是性能旗舰。在数学、STEM、竞赛型代码的评测中,V4-Pro 超越了当前所有已公开评测的开源模型,成绩追…
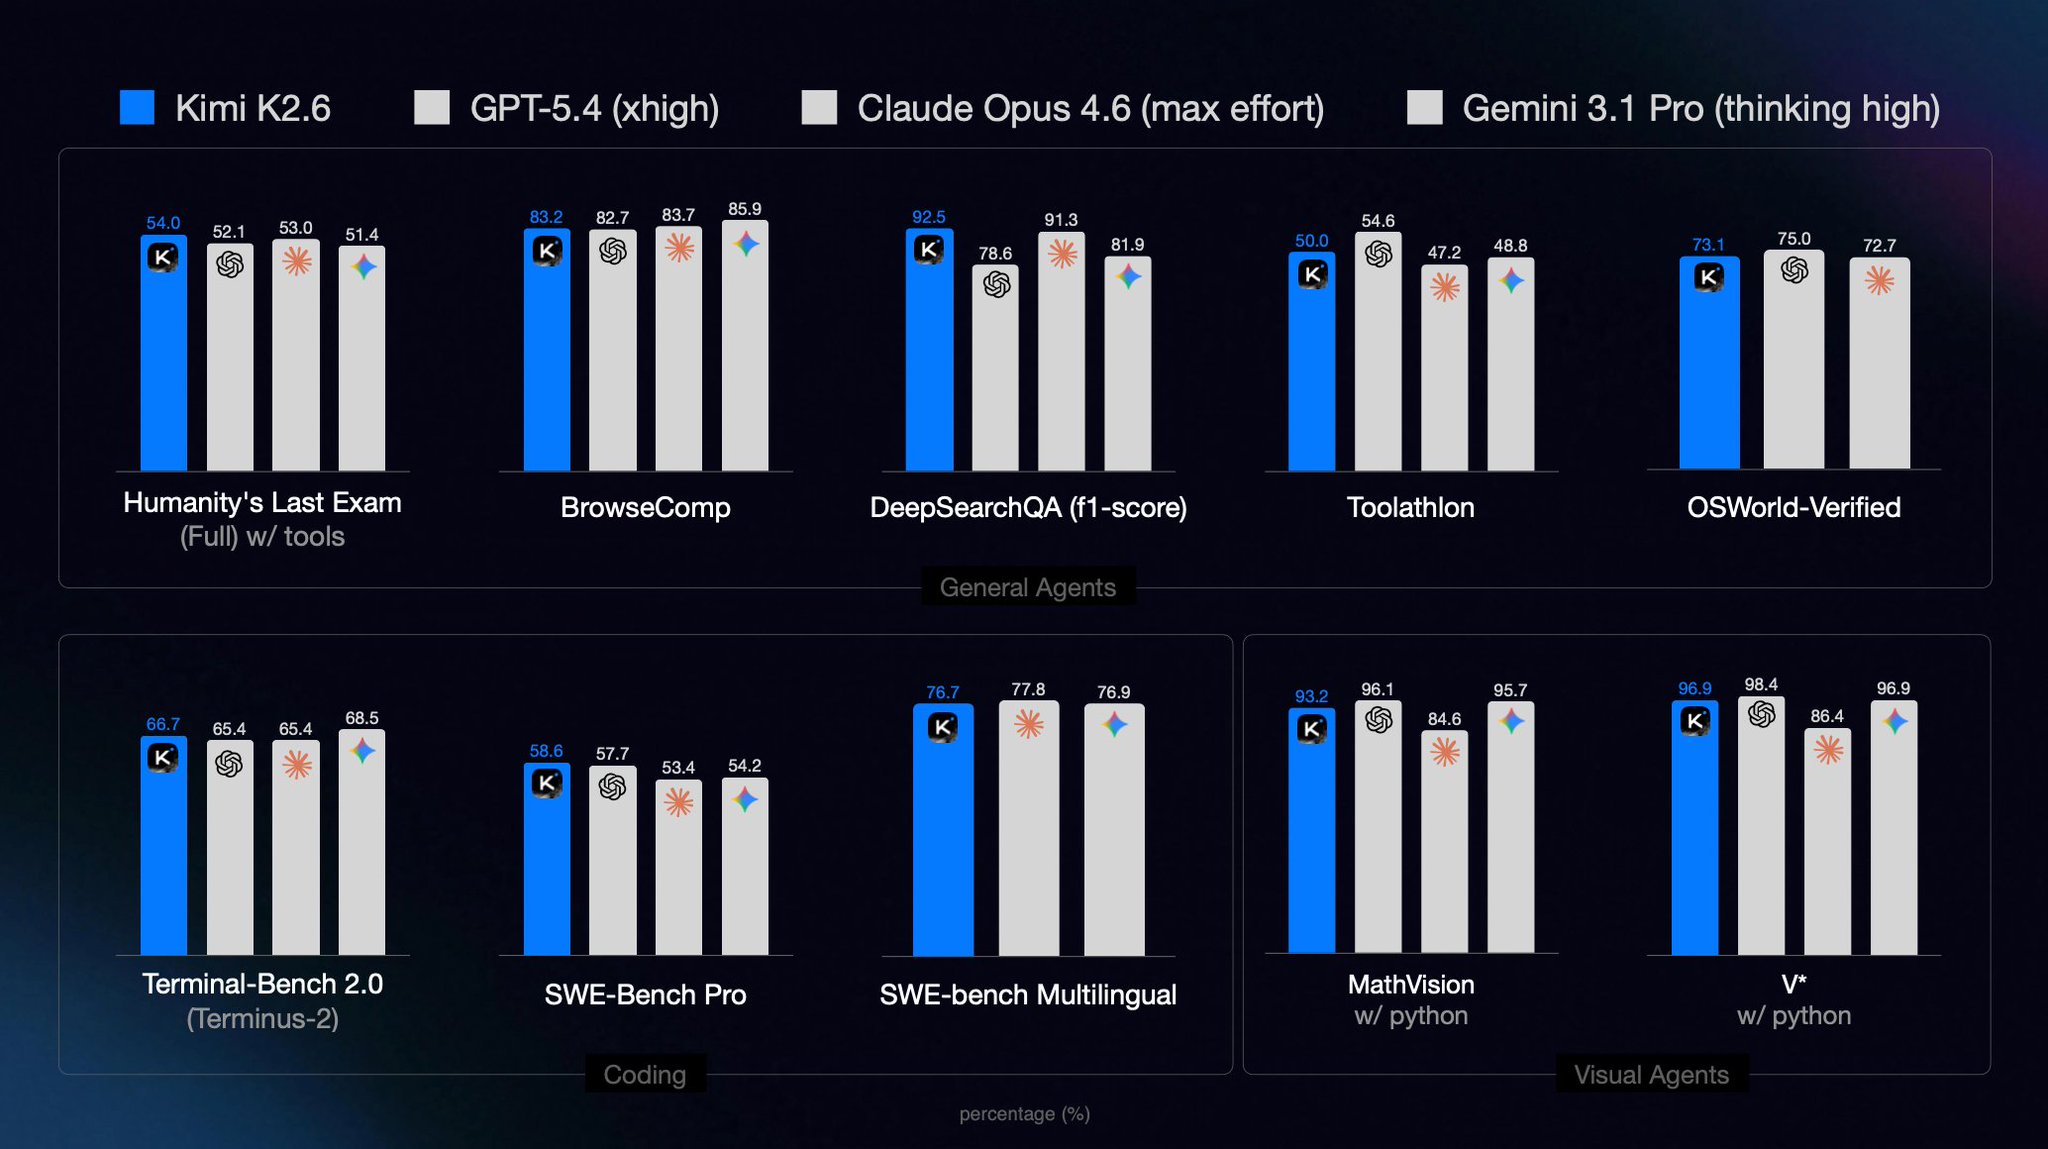
月之暗面(Moonshot AI)发布了 Kimi K2.6 模型,在多项主流 Agent 和编码基准测试中取得开源 SOTA,多项指标追平甚至超越 GPT-5.4、Claude Opus 4.6 等闭源模型。 Kimi K2.6 Benchmark 基准表现 与 GPT-5.4 (xhigh)、Claude Opus 4.6 (max effort)、Ge…
Google Research 公布了 TurboQuant,并同时介绍 QJL 与 PolarQuant。三套方法都围绕同一个问题:高维向量太占内存,长上下文大模型里的 KV 缓存和向量搜索系统都会被带宽与容量拖住。 TurboQuant 给出的结果很激进:在无需训练或微调的情况下,它能把 KV 缓存量化到 3 比特。在 long-context 的 ne…
腾讯撤销 AI Lab,密集引入字节 Seed 骨干推进混元升级 腾讯这轮 AI 调整,已经从继续加码走到重新排兵布阵。 据《智能涌现》报道,腾讯近期持续重组大模型研发体系:一边撤销 AI Lab,原团队部分人员转入大语言模型部;另一边,则把多位原字节 Seed 技术骨干集中补到 AI Infra 与 RL 相关岗位。结合腾讯管理层在财报电话会上的表态来看,…