2026 年 9 月 22 日,Anthropic 发布 Claude Opus 5.5,Claude 5.5 系列的第一款模型。同一个下午,OpenAI 放出 GPT-6 Sol 和 GPT-6 Luna。两家公司在同一天各自更新了主力产品线,这在这两个品牌的发布史上还是第一次。
Opus 5.5 的核心卖点用一句话概括:性能对齐自家旗舰 Fable 5.1,价格却是它的六折以下。这已经超出了例行换代的范畴:Anthropic 第一次把「前沿能力」从旗舰价位拉到中端价位。
基准成绩:三条代理编码线全部登顶
先看官方 benchmark 表格:
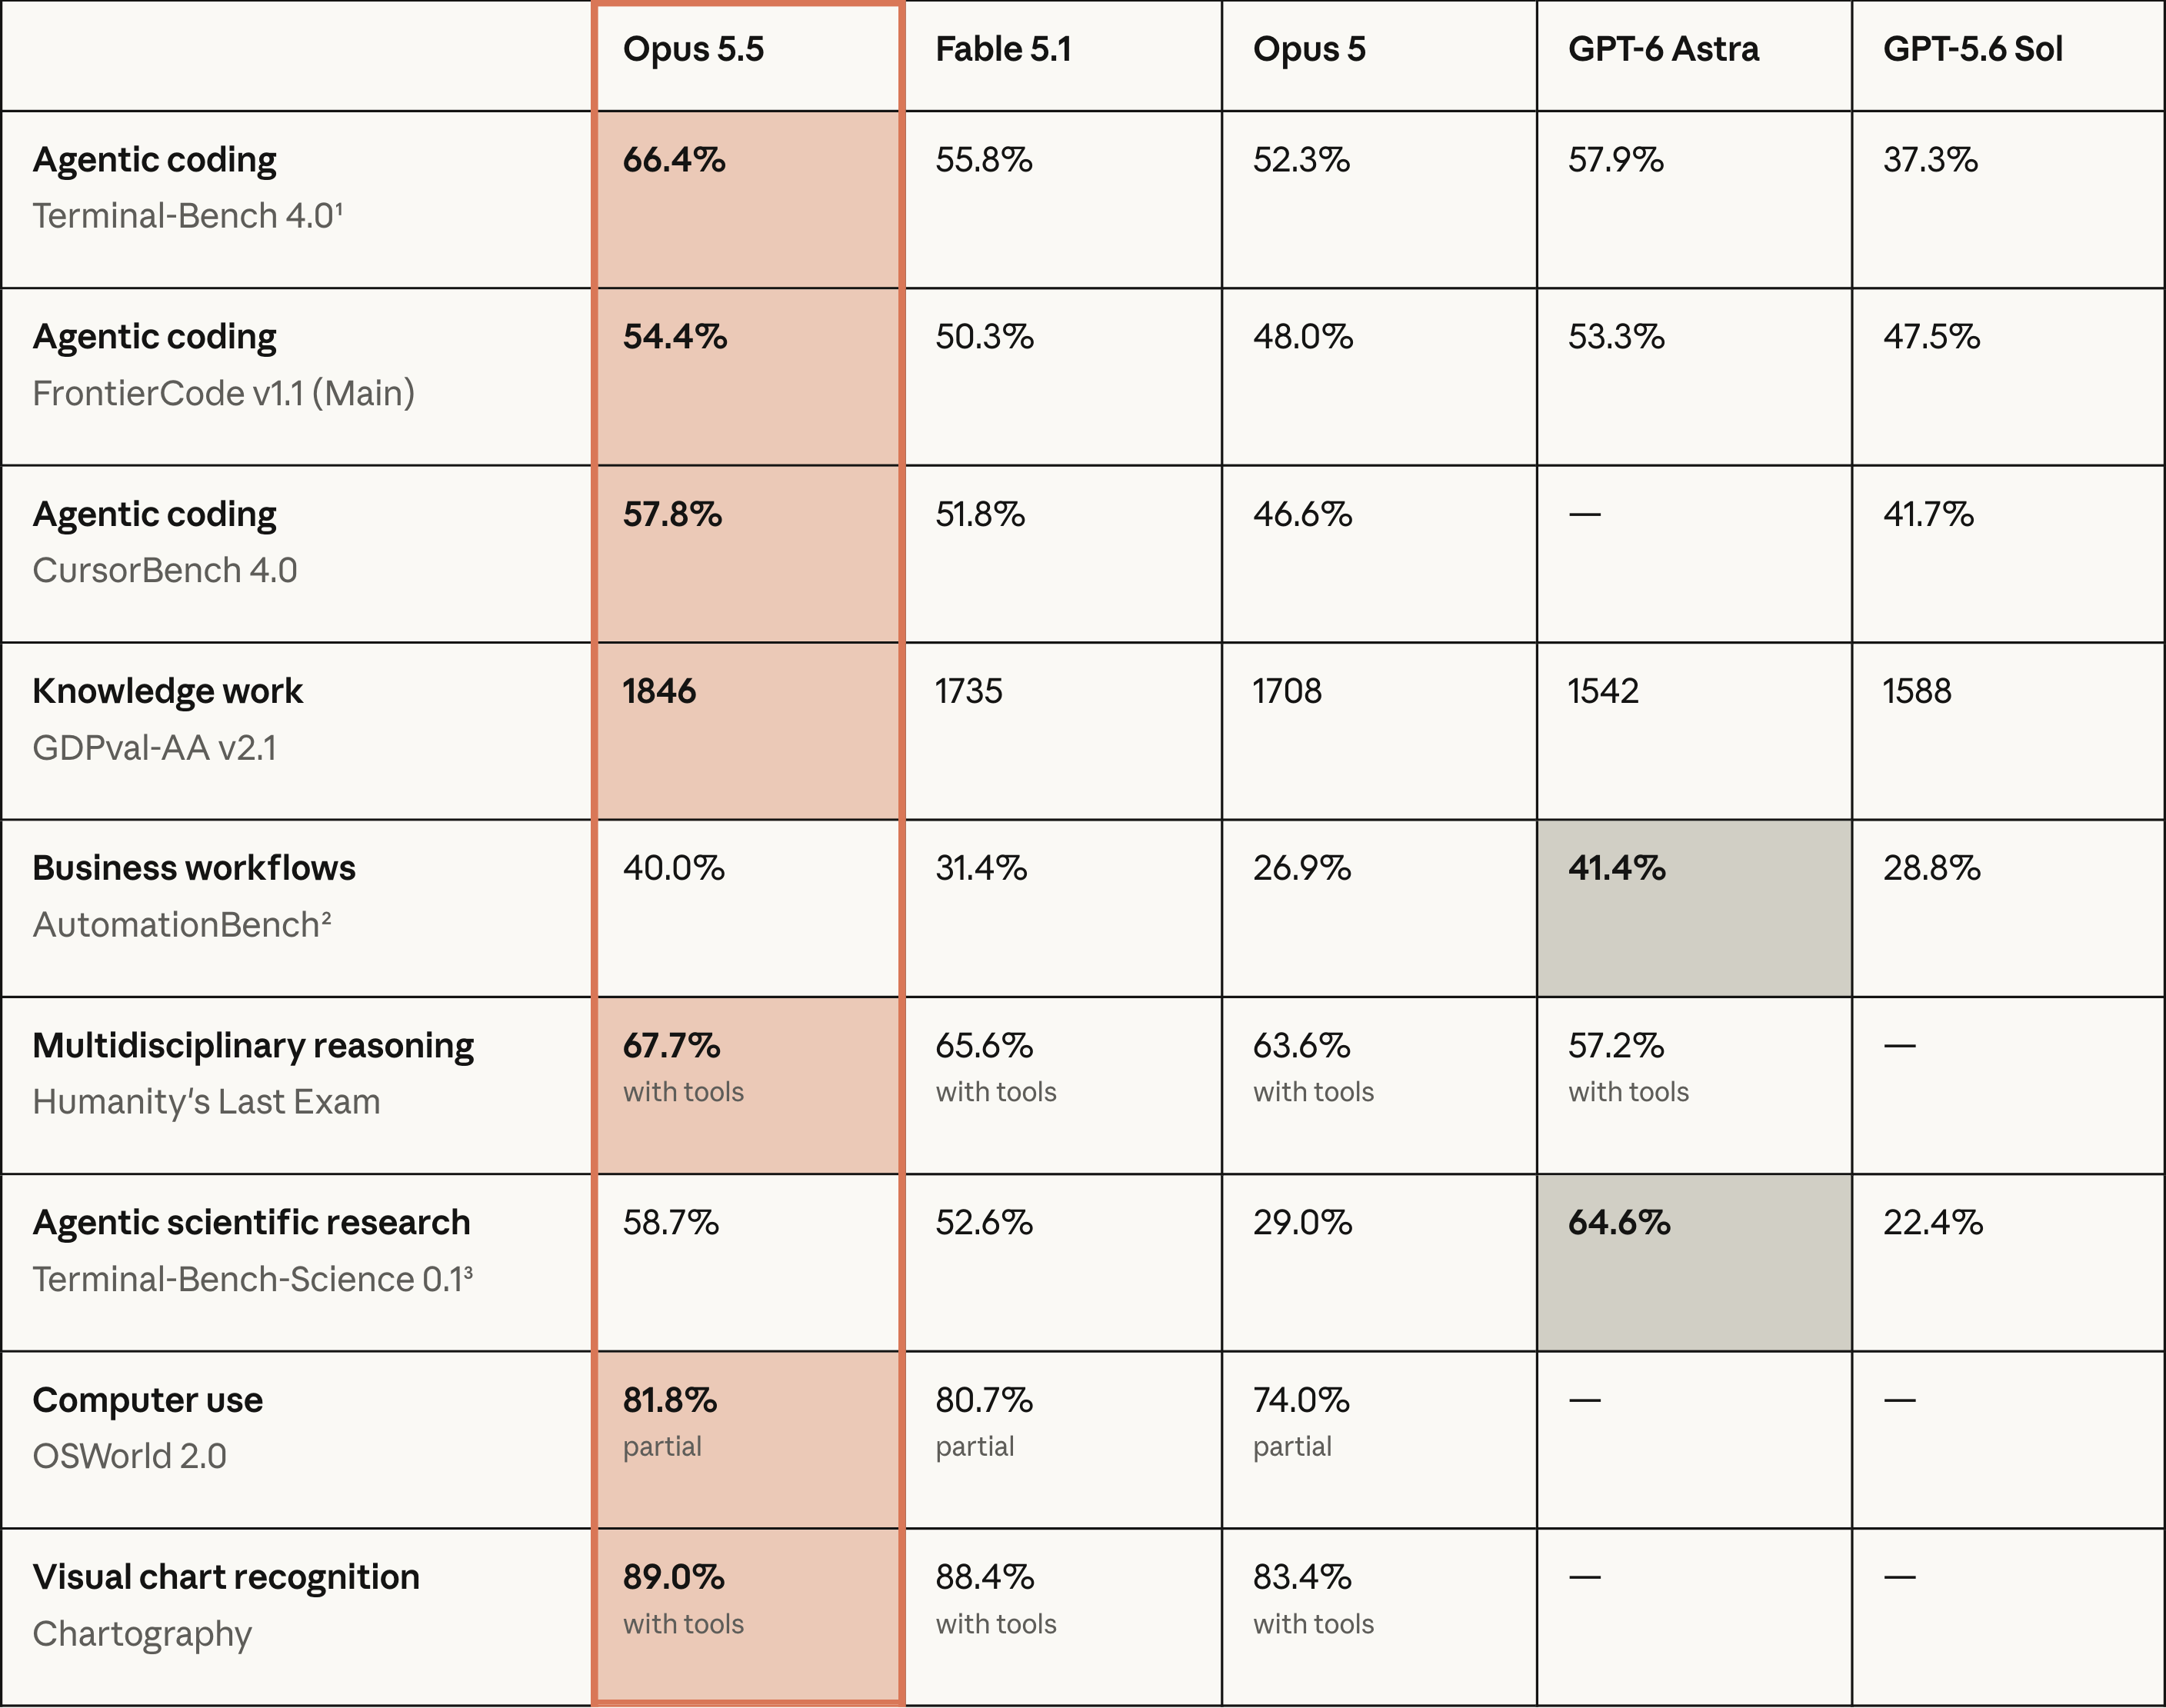
代理编码(agentic coding)三个基准上,Opus 5.5 全部第一:
| 基准 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1 (Main) | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| Humanity's Last Exam | 67.7%(带工具) | 65.6% | 63.6% | 57.2% | — |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0(计算机操作) | 81.8% partial | 80.7% | 74.0% | — | — |
| Chartography(图表识别) | 89.0%(带工具) | 88.4% | 83.4% | — | — |
几个值得单独看的数据点:
- Terminal-Bench 4.0 的 66.4% 是目前所有公开模型里的最高分。GPT-6 Astra 的 57.9% 是 OpenAI 自己报告的最高强度(high effort)成绩。注意标准误差 ±2.6 个点,这个差距超出了噪声范围。
- Terminal-Bench-Science 是唯一输给 GPT-6 Astra 的主项(58.7% vs 64.6%)。而且脚注写明:当安全护栏介入时,网络安全类任务会转交给 Opus 4.8 完成、生物类任务转交给 Opus 5,这部分成绩被计为 Opus 5.5 的失败,拉低了实际分数。
- GDPval-AA 的 1846 Elo 领先 Fable 5.1 一百多分,这个差距在同一榜单里相当于一个档位的差距。
Anthropic 自己在发布页里也说了句实话:在这个能力水平上,benchmark 分差已经不是真实世界差距的可靠指标,他们自己用下来,Opus 5.5 和 Fable 5.1 的差距比分数显示的更小。
成本结构:四个价格全部下调
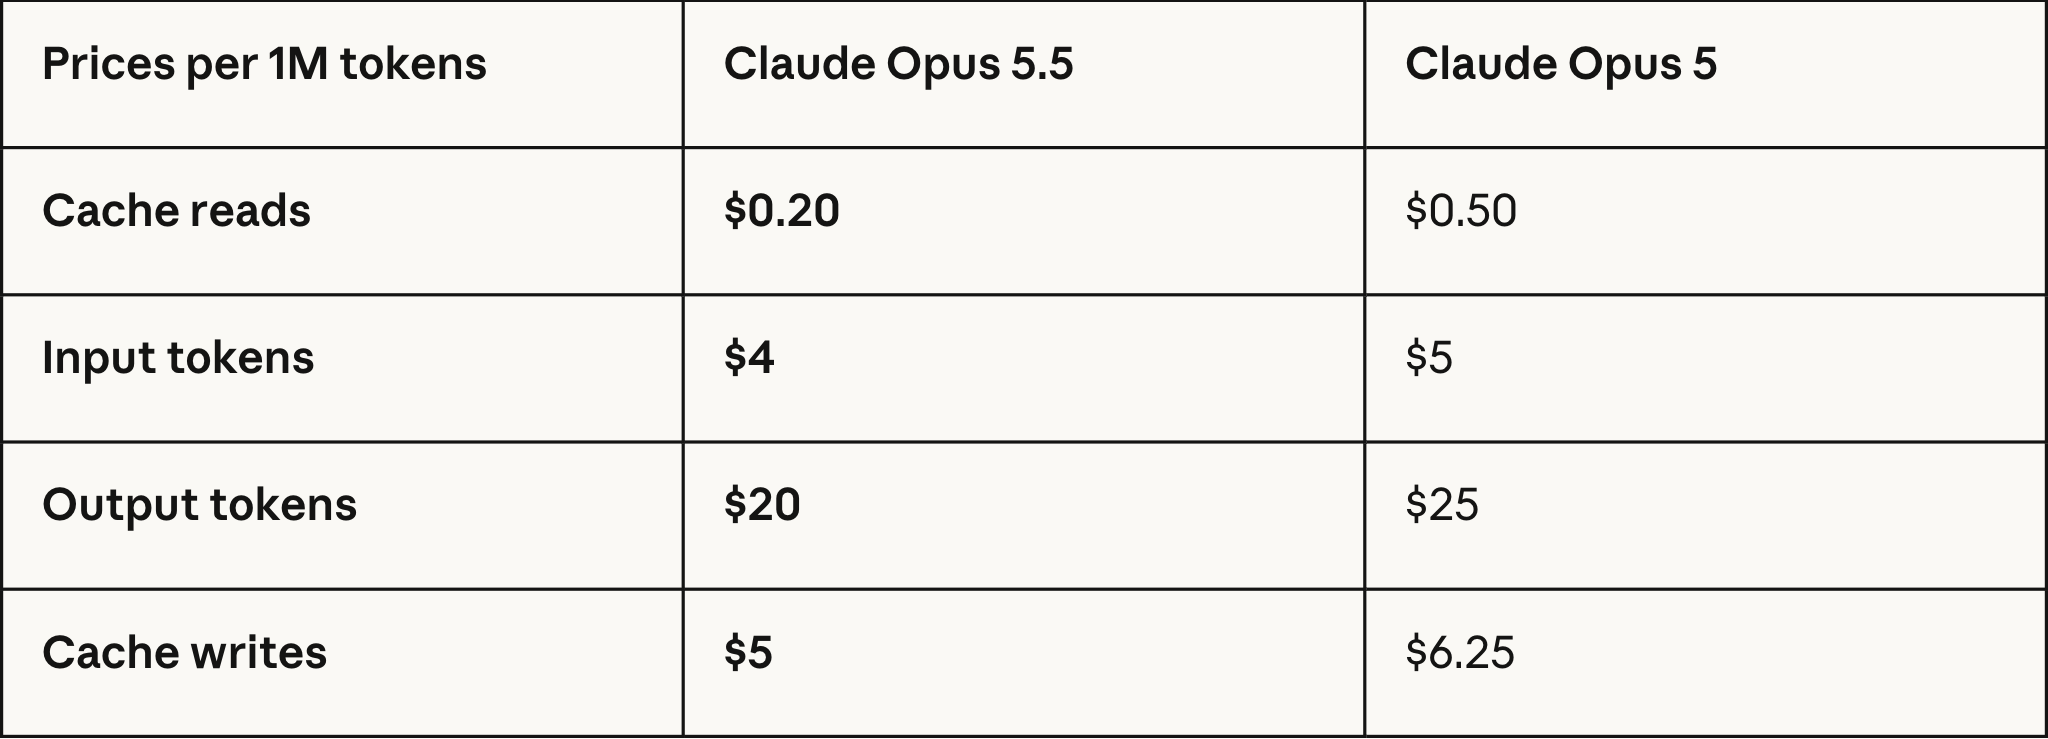
Opus 5.5 的完整价格(每百万 token):
| 项目 | Opus 5.5 | Opus 5 | 降幅 |
|---|---|---|---|
| 缓存读取 | $0.20 | $0.50 | -60% |
| 输入 token | $4 | $5 | -20% |
| 输出 token | $20 | $25 | -20% |
| 缓存写入 | $5 | $6.25 | -20% |
单价降幅最大的是缓存读取(60%),这个数字瞄准的是代理工作负载:编码 agent 的成本大头是反复读取同一段上下文,缓存读取价格直接决定长任务的边际成本。Anthropic 给出的综合估算是:默认设置下,典型工作负载的总成本比 Opus 5 低 40%,来源是两部分叠加,单价降了,每个任务的 token 用量也降了。
输出速度比 Opus 5 快 30% 以上。订阅端(Pro/Max/Team/Enterprise)的五小时用量限制同步上调。
快速模式(Fast mode)上限 2.5 倍速,价格 $8/$40,适合交互式场景等不起常规出码速度的场合。
效率曲线:三张散点图里的真正故事
这次发布最有信息量的地方在官方散点图里。横轴是每次尝试的成本(对数刻度),纵轴是得分,每条线上的点是模型在不同 effort 档位下的位置:
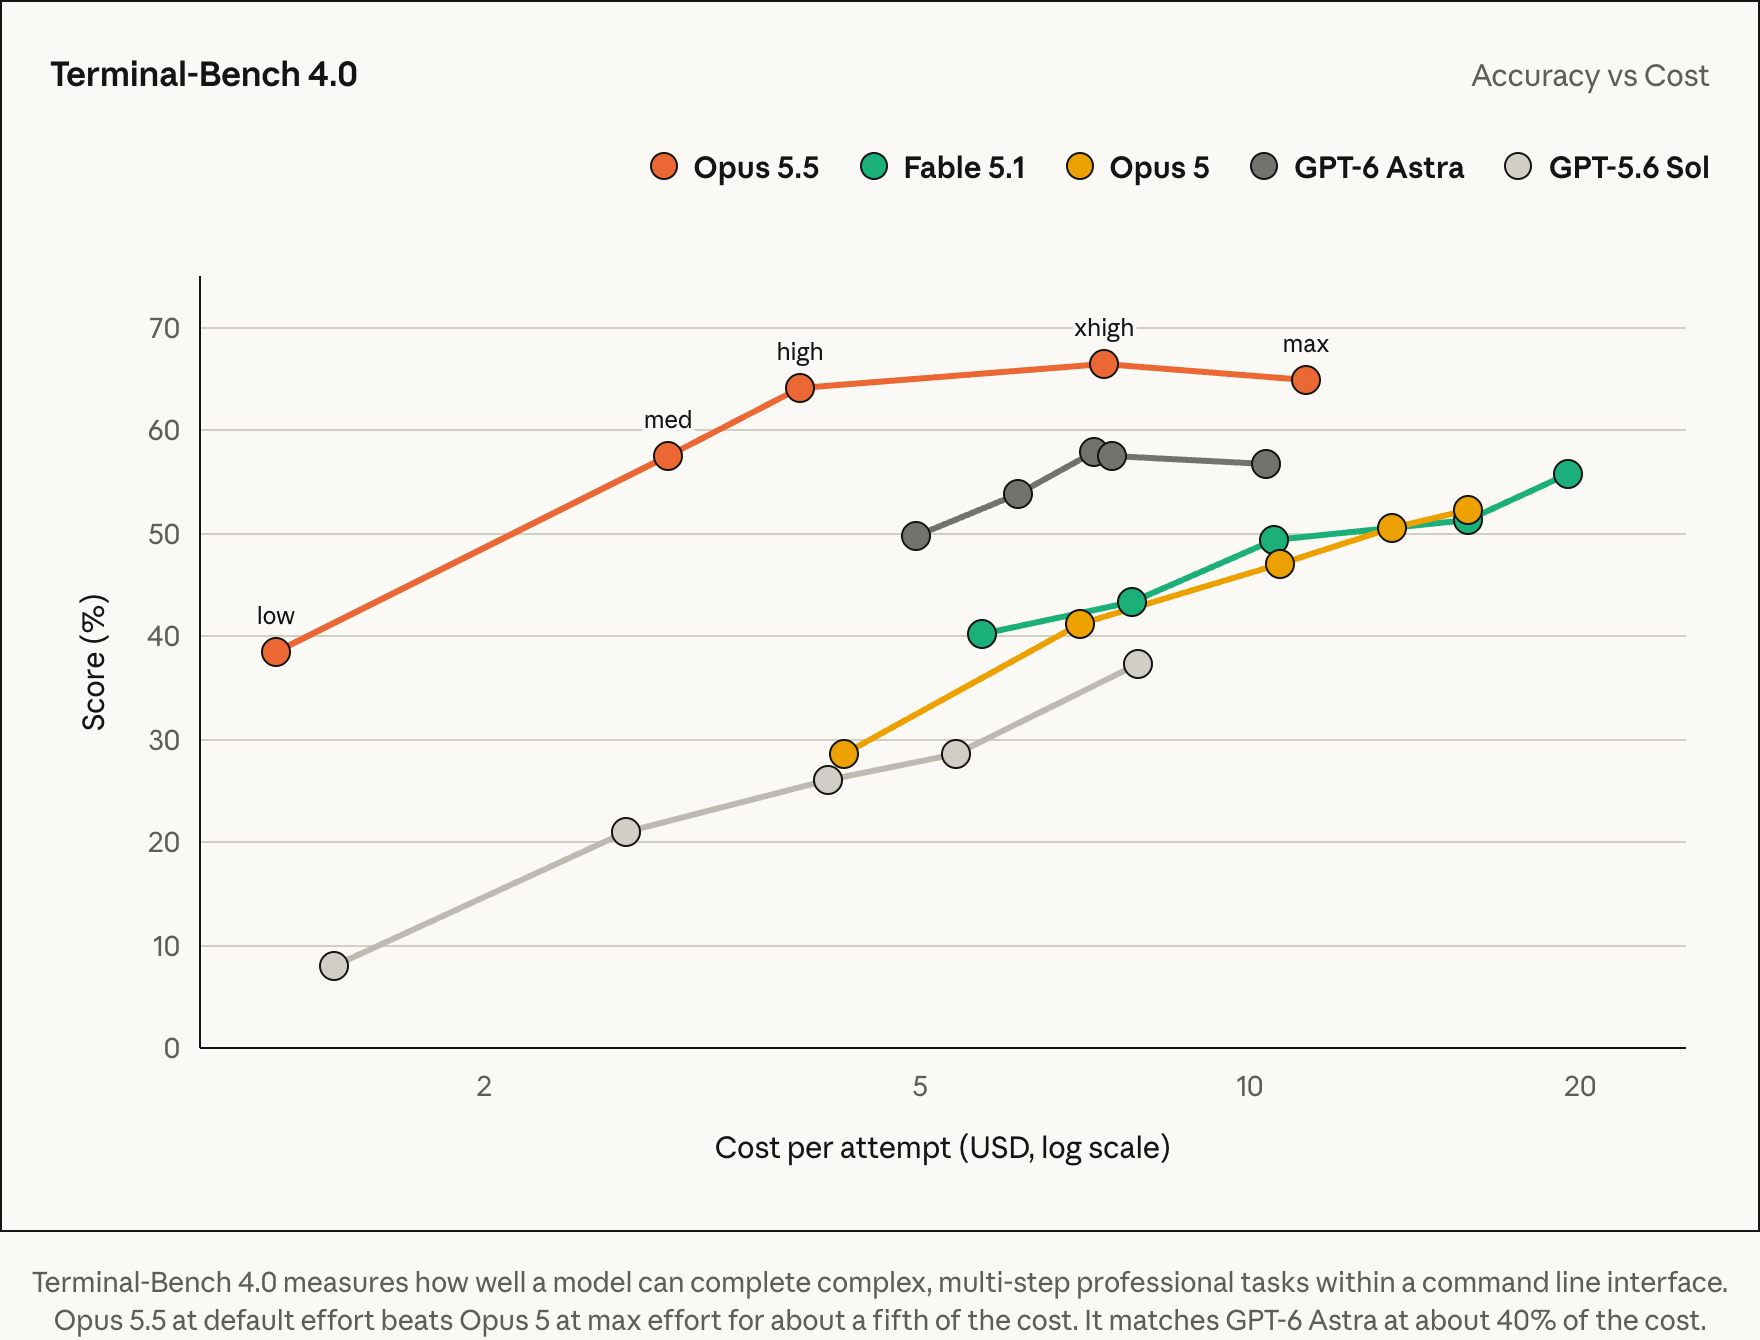
Terminal-Bench 4.0 上,Opus 5.5 的 low effort(约 $1.2/次,38%)就已经超过 Opus 5 的 high effort;它的默认档(med,约 57%)以大约五分之一的成本打平 GPT-6 Astra 的最高档;xhigh 档 66.4% 的成本约为 Astra max 的 40%。
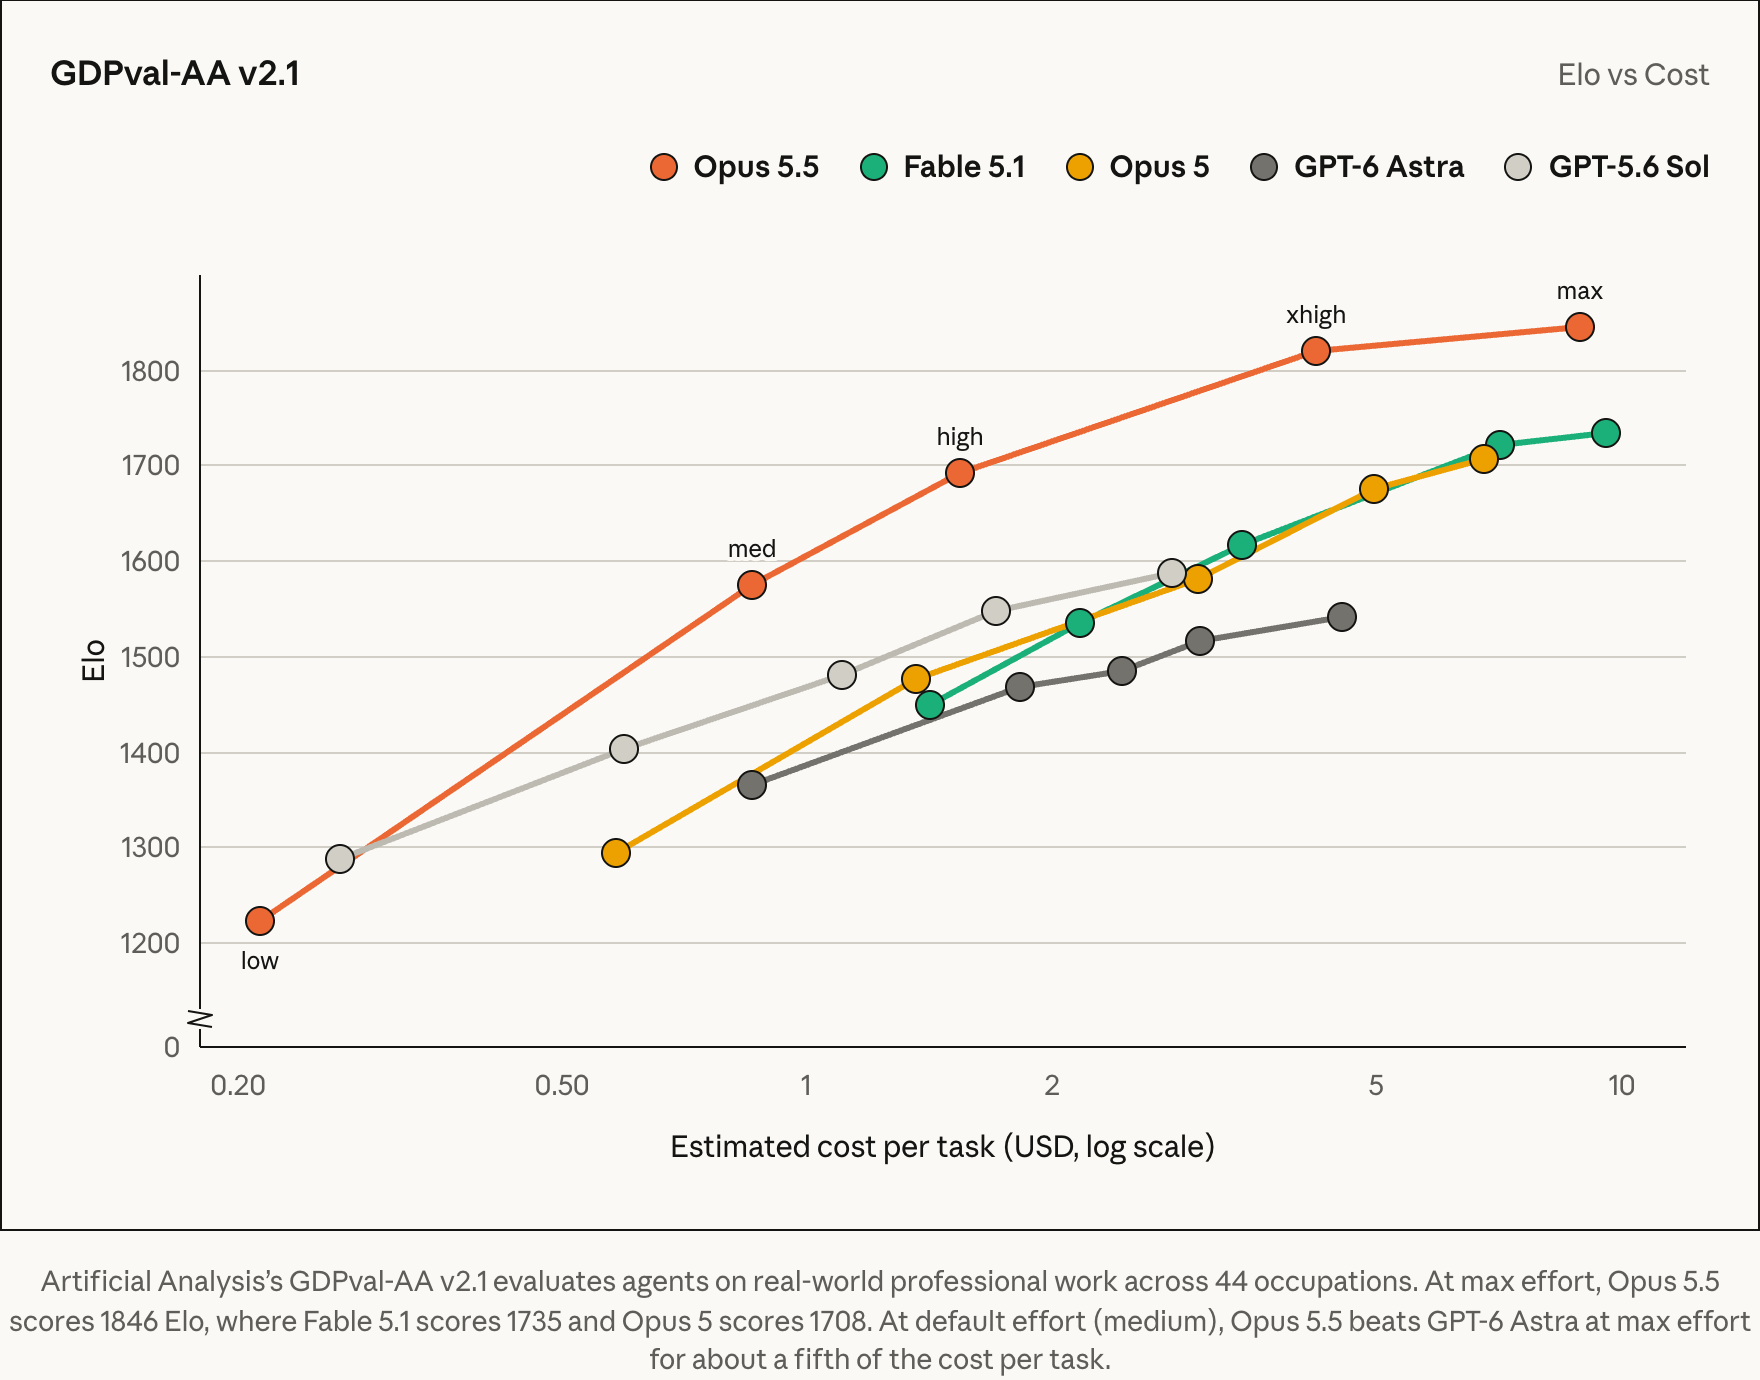
GDPval-AA 上形态相同:Opus 5.5 默认档(med,约 $0.8/任务,1573 Elo)压过 GPT-6 Astra 的最高档(约 $4/任务,1542 Elo)。官方脚注写的就是这个对比:默认档打赢对手最高档,成本是它的五分之一。
HAProxy 的内部实验把这个效率差放到了真实工程上:让 Opus 5.5 和 Fable 5.1 各自把 HAProxy 从 C 翻译成 Rust。两个模型的改写都几乎通过了 HAProxy 自己的全部回归测试,但 Opus 5.5 用了 9.5 小时(Fable 5.1 是 12 小时),成本低 51%。早期测试者的两个案例:一个 68 万行的代码迁移在一天内完成;另一个 20 万行代码库的审计修复,Opus 5.5 用了不到 3 小时,Opus 5 需要 20 小时以上且消耗 2.5 倍的 token。
GitHub 产品负责人 Mario Rodriguez 提供的数据是同一个方向:在 Copilot CLI 和 VS Code 的测试里,Opus 5.5 解决的终端任务比 Opus 5 多,用的步骤却不到一半。这些是厂商挑选的客户结果,不是独立评测,但指向的指标是行业正在收敛的那个:任务完成前的编排次数、重试次数和 token 消耗。
与 GPT-6 Sol 的正面相撞
OpenAI 同日发布的 GPT-6 Sol 定价 $2/$10,正好是 Opus 5.5 裸价的一半;GPT-6 Luna 定价 $0.10/$0.50,走的是量抽层。这是两家第一次在同一天发布直接对位的模型档位。
两家的考卷却互相错开:
- OpenAI 报 GPT-6 Sol 在 AutomationBench 1.0.6 xhigh 上拿 33.2%、每任务 $0.27;Anthropic 报 Opus 5.5 在 Zapier 早期内测的 AutomationBench 上拿 40.0%。两组数字的评测环境不同,OpenAI 的对手数据来自公开报告而非同一环境复测,不能当作同条件对垒。
- OpenAI 声称 Sol 在 FrontierCode 1.1 Main 上以远低成本达到 Fable 5.1 xhigh 的水平;Anthropic 的榜单里 Opus 5.5 在同一基准上高于 Fable 5.1。两边都没发布过同 harness 下的正面对照。
换句话说:目前不存在任何一份 Opus 5.5 对 GPT-6 Sol 的同条件公开评测。两家各自画的效率曲线都真实,但坐标原点不一样。采购决策在第三方榜单(如 Artificial Analysis 的 GDPval-AA,Anthropic 已引用)出现两家的同轮数据之前,只能靠内部 workload 自测。
缓存是另一个暗线:OpenAI 给 GPT-6 系列的缓存输入 9 折折扣,Sol 的名义缓存读价约 $0.20,与 Opus 5.5 的 $0.20 打平(Luna 低至 $0.01);且 GPT-6 声称在改动 reasoning effort 或开关工具时保留缓存上下文,这对长会话 agent 的缓存命中率影响很大。
开发者迁移:四条 breaking changes
claude-opus-5-5 的上下文窗口 100 万 token,同步输出上限 12.8 万 token(Message Batches API beta 配置可到 30 万)。但 Opus 5.5 不是 Opus 5 的即插即用替换,官方文档列出的行为变化有四类,每一条都戳在 agent 系统的架构上:
- Adaptive thinking 常开。不能再关闭思考,只能用
effort参数控制深度。依赖「关思考省 token」的调用路径需要重写。 - 强制工具调用可能返回错误。工作流里假定 tool use 必成功的分支要加失败处理。
- thinking block 与产生它的模型和会话绑定。跨会话复用 thinking block、或者把 thinking block 喂给别的模型的管道会失效。
- 工具调用之间的文本输出语义变化。把工具间文本当作进度更新展示的应用,需要重新处理 thinking block 的位置。
安全侧的变化同样是运行时行为:部分网络安全请求会被透明路由到 Opus 4.8,敏感生物任务可能回退到 Opus 5。Vetted 组织可以通过 Life Sciences Verification Program 和 Cyber Verification Program 申请更宽的权限。
对齐评测方面,Opus 5.5 在 Anthropic 约 2000 个场景的自动化行为审计里是该公司测过的最强模型;新的遏制评测里,它尝试绕过边界的频率比 Opus 5 和 Mythos 5.1 低约 85%。Anthropic 同时承认:在部署前可靠地检测每一种失败仍然是无解问题。
定位判断:Anthropic 的价格卡位与模型分层
把今天的发布放回整个市场:Opus 5.5 的 $4/$20 卡在 GPT-6 Sol($2/$10)和 GPT-6 Astra($10/$50)正中间,而 Fable 5.1/Mythos 5.1($10/$50)退守旗舰档。VentureBeat 整理的全市场价格表里,$24 的 Opus 5.5 上方只剩 Sakana Fugu Ultra、自家 Fast mode 和三家旗舰,下方是 GPT-6 Sol、Sonnet 5 和一众国产模型。
这构成了一个三层结构:最难最含糊的任务给旗舰(Fable 5.1/Astra),重复性执行给中档(Opus 5.5/Sol),高量低难度的子任务给廉价层(Luna/MiMo-V2.6-Flash/DeepSeek-V4.1-Flash)。Anthropic 自己对 Opus 5.5 的定位描述很明确:长期运行的编码 agent、研究和专业知识工作。这类负载的共同特征是单任务多轮次、上下文复用率高,恰好是缓存读降价 60% 收益最大的地方。
对普通开发者的直接影响:Phantom 之前按 Opus 5 价格计费的工作流,切到 Opus 5.5 后单价立省 20%;如果你的 agent 每个任务平均用掉 Opus 5 一半的 token(GitHub 和 Lovable 的测试数据),总成本降幅会接近官方宣称的 40%。订阅用户(Claude Code、Claude App)不需要做任何事,直接在模型选择器里切换即可;API 用户则要先过一遍上面四条 breaking changes,尤其是 thinking block 生命周期那条。
Two frontier labs, one day, two price lists. 编码 agent 的单位成本曲线从今天起需要重新画一遍。
来源:
- Introducing Claude Opus 5.5 — Anthropic 官方发布页(benchmark 数据、价格、安全机制、HAProxy 实验均出自此页)
- Anthropic releases Claude Opus 5.5 — VentureBeat(全市场价格对比表、breaking changes 细节、GitHub/GitHub CPO 引述)
- OpenAI 发布 GPT-6 Sol 和 Luna 模型 — IT之家(GPT-6 Sol/Luna 定价与 AutomationBench 数据,转述 OpenAI 官方公告)